Я справді люблю DBT.
Це інструмент, що полегшує життя аналітика, але справа навіть не лише в цьому. Вивчаючи DBT, ви не просто освоюєте новий інструмент – ви починаєте краще розуміти, як загалом слід працювати з даними. Тому мені дуже хочеться, щоб якомога більше моїх колег також розібралися в ньому та побачили його цінність.
Під час знайомства з DBT ви зіткнетеся з ключовими принципами роботи з даними: як їх структурувати, як ними керувати, як будувати зрозумілу й гнучку модель даних, як запускати скрипти у певній послідовності, як працювати з документацією тощо. Це не просто SQL-трансформації — це спосіб глибше зануритися в аналітику та її професійне середовище. І якщо після цієї статті вам захочеться не лише освоїти DBT, а й розібратися з іншими інструментами аналітики даних – значить, я досяг своєї мети.
0. Невеликий вступ
Багато хто з нас прийшов у професію “зі сторони”, зі суміжних галузей: маркетингу, таргетованої реклами, продажів, логістики, фінансів. Часто перші кроки у вебаналітиці починаються в межах однієї екосистеми – зазвичай Google. Це зручно: Google Analytics 4, Google Tag Manager, Google BigQuery, Looker Studio (by Google) — усі інструменти пов’язані між собою, налаштовуються в кілька кліків і дають швидкий результат. Але така ізольованість знань створює проблему: фахівець бачить лише те, що знаходиться всередині однієї екосистеми, і не завжди розуміє, що відбувається поза межами.
Насправді ж за її межами існує величезний світ інструментів, що складають так званий Modern Data Stack – сучасний підхід до роботи з даними, що використовує найкращі рішення для кожного етапу обробки даних. Однією з ключових частин цього стека є DBT (Data Build Tool). Він відповідає за процес трансформації даних (літера «T» у процесах ETL/ELT), допомагаючи структурувати, тестувати та керувати моделями даних на принципах програмної інженерії.
Якщо ви спробуєте загуглити Modern Data Stack, то, найімовірніше, побачите сотні різних інструментів (один із таких прикладів наведено на скріншоті нижче. Сама картинка взята зі статті на медіумі Key Trends in Modern Data Stack). Це може виглядати заплутано: десятки логотипів, складні схеми, безліч варіантів стеків… Як у цьому всьому розібратися?
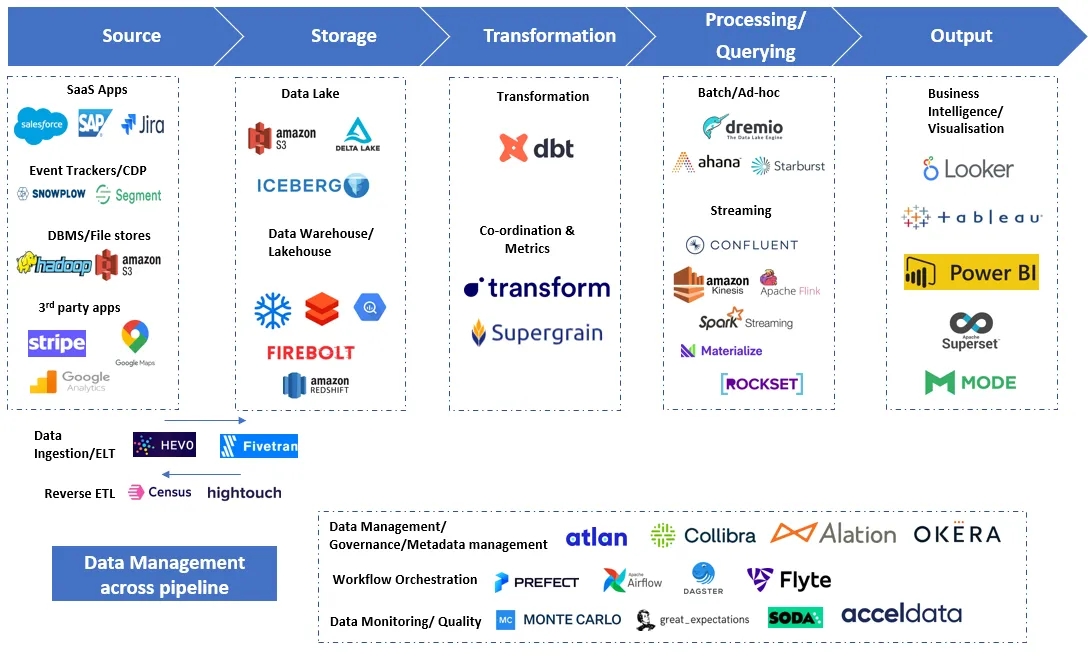
Насправді, якщо уважно подивитися на всі ці схеми, можна помітити, що вони поділяються на блоки: Source, Storage, Transformation, Processing, Output. Це певні етапи роботи з даними, кожен із яких виконує свою ключову функцію. Якщо спростити логіку (насправді значно спростити, бо схема значно складніша. Я це роблю усвідомлено, для розуміння), можна звести все до класичної моделі ETL або ELT, які розшифровуються як Extract (витягнути дані), Transform (перетворити); Load (завантажити).
А далі згідно ланцюжка: Звідки відбувається Extract? Чим виконується Transform? Куди завантажуються дані на етапі Load? Усі ці інструменти так чи інакше передбачають, що дані витягуються з певного джерела, проходять обробку, десь знову зберігаються, а потім надсилаються на візуалізацію.
Саме на етапі Transform ключову роль відіграє DBT. Він відповідає за перетворення даних, роблячи їх чистими, структурованими та придатними для аналізу. Тому DBT є одним із ключових компонентів Modern Data Stack, що визначає, як будується аналітика даних у сучасній компанії.
Якщо ви ще раз перегляните схеми Modern Data Stack, які з’являються в різних статтях, на форумах або в доповідях, то помітите закономірність: DBT присутній майже завжди. Деякі інструменти з'являються й зникають, змінюючись залежно від стеку та вподобань команди, але DBT стабільно залишається частиною стека. Це означає, що DBT – не просто черговий інструмент, а галузевий стандарт, яким користуються повсюдно, незалежно від хмарної платформи чи сховища даних.
Буквально днями мені трапилася стаття про популярні аналітичні інструменти минулого року, яка вкотре наочно продемонструвала, яке важливе місце серед них займає DBT.
Більше того, навіть Google усвідомлює важливість цього підходу і намагається інтегрувати аналогічний інструмент у свою екосистему – Dataform. По суті, це спроба створити «власний DBT», вбудований у Google Cloud Platform. Наразі його функціональність у деяких аспектах поступається DBT, проте концепція залишається тією ж самою: керування трансформаціями даних через код. А це означає, що, розібравшись із DBT, ви без зусиль зможете адаптуватися і до Dataform, якщо він стане основним інструментом у межах екосистеми Google.
Ну що – готові побачити новий горизонт своєї спеціальності? Тоді вперед!
(Тільки врахуйте – зворотного шляху, скоріше за все, вже не буде.)
Отже, DBT існує у двох варіантах: DBT Cloud і DBT Core
DBT Core – це open-source версія (звісно, безкоштовна), яку можна встановити локально і запускати через командний рядок. Вона надає всі основні можливості DBT: написання моделей, тестування, деплой через CI/CD. Однак налаштування та керування проєктом повністю лежать на користувачеві.
DBT Cloud – це хмарний сервіс, що спрощує роботу з DBT. Він включає в себе зручний вебінтерфейс, автоматичне планування запусків (scheduler), керування користувачами, інтеграції зі сховищами даних і підтримку командної роботи. Безкоштовна версія доступна для одного користувача. Для команди — платна. Однак її вартість значно нижча за ті переваги, які ви отримуєте.
Простіше кажучи, DBT Core – для тих, хто хоче повний контроль, незалежність і гнучкість (але для цього потрібно мати глибокі технічні навички). А DBT Cloud – для тих, хто надає перевагу зручності та мінімальним налаштуванням, іншими словами – для початківців, які лише знайомляться з логікою роботи DBT. У ньому вже є готові налаштування «з коробки», а інтуїтивно зрозумілий інтерфейс допомагає швидше розібратися, як усе працює.
Тому, якщо у вас немає просунутих технічних навичок, але ви хочете освоїти DBT, я рекомендую почати саме з DBT Cloud. Він дозволяє швидко зануритися в процес, не витрачаючи час на складну конфігурацію.
Під час написання цієї статті я використовуватиму скріншоти як із DBT Cloud, так і з DBT Core. Це пояснюється тим, що деякі переваги DBT краще демонструвати на прикладі Core-версії. Хоча всі ці можливості є і в Cloud, у деяких випадках вони виглядають наочніше саме в Core. Тому у статті будуть приклади з обох варіантів, щоб максимально точно передати функціональність DBT і продемонструвати його ключові особливості.
Думаю, для вступу цього більш ніж достатньо – навіть вийшло об’ємніше, ніж планувалося. Тепер пора переходити до переваг DBT. Їх дійсно багато, але щоб не перевантажувати матеріал, я виділю п’ять ключових, які допоможуть структуровано подати інформацію та пояснити кожен аспект більш детально.
- Організація даних у проєкті
- Контроль якості даних
- Контроль версій скриптів
- Оркестрація
- Потужна навчальна платформа
А далі, у процесі роботи з DBT, ви самі будете відкривати для себе нові зручності та можливості, які зроблять вашу роботу з даними простішою та ефективнішою.
Організація даних у проєкті
Поганий той аналітик, який не прагне упорядкувати та структурувати свої дані. Коли у вас лише 3–5 таблиць, ще можна утримати в голові, звідки що береться, які дані пов’язані між собою та для кого вони призначені. Але щойно їхня кількість перевалює за десятки, розібратися у всьому цьому без чіткої структури стає майже неможливо.
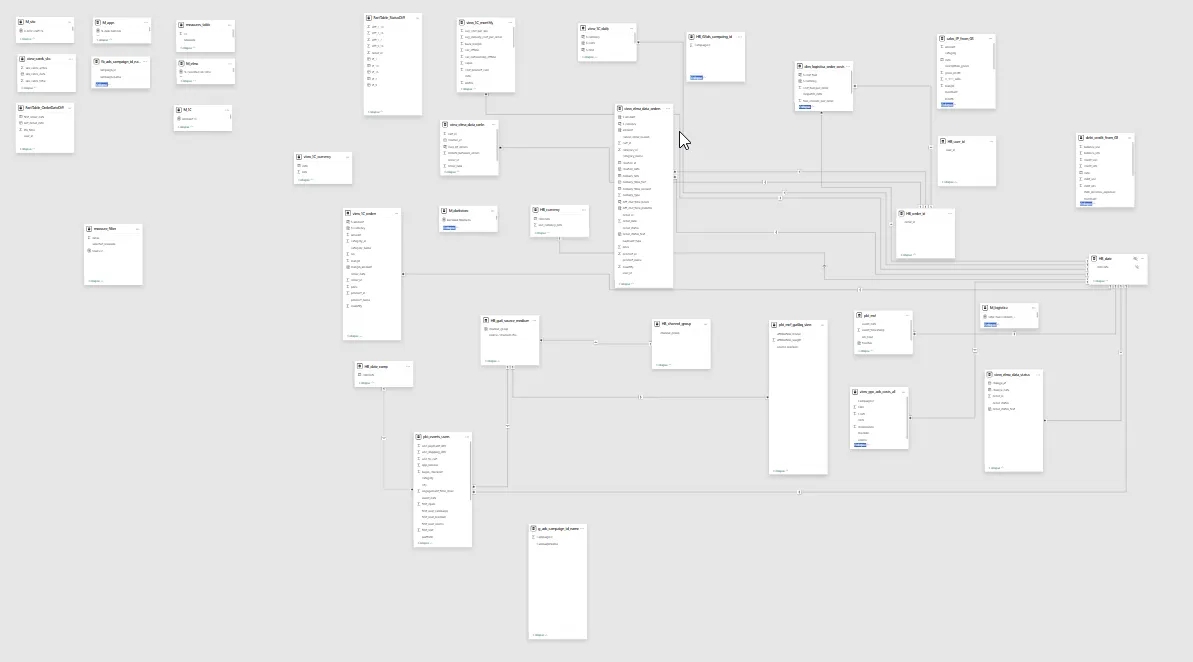
Без єдиної системи організації, документації та розуміння схеми даних легко загубитися: Які дані надходять і звідки? Які проміжні таблиці беруть участь у формуванні фінальних звітів? Де зберігаються дані для різних відділів та кінцевих користувачів? Без структури та документації робота аналітика перетворюється на хаос, а підтримка проєкту стає складною і витратною.
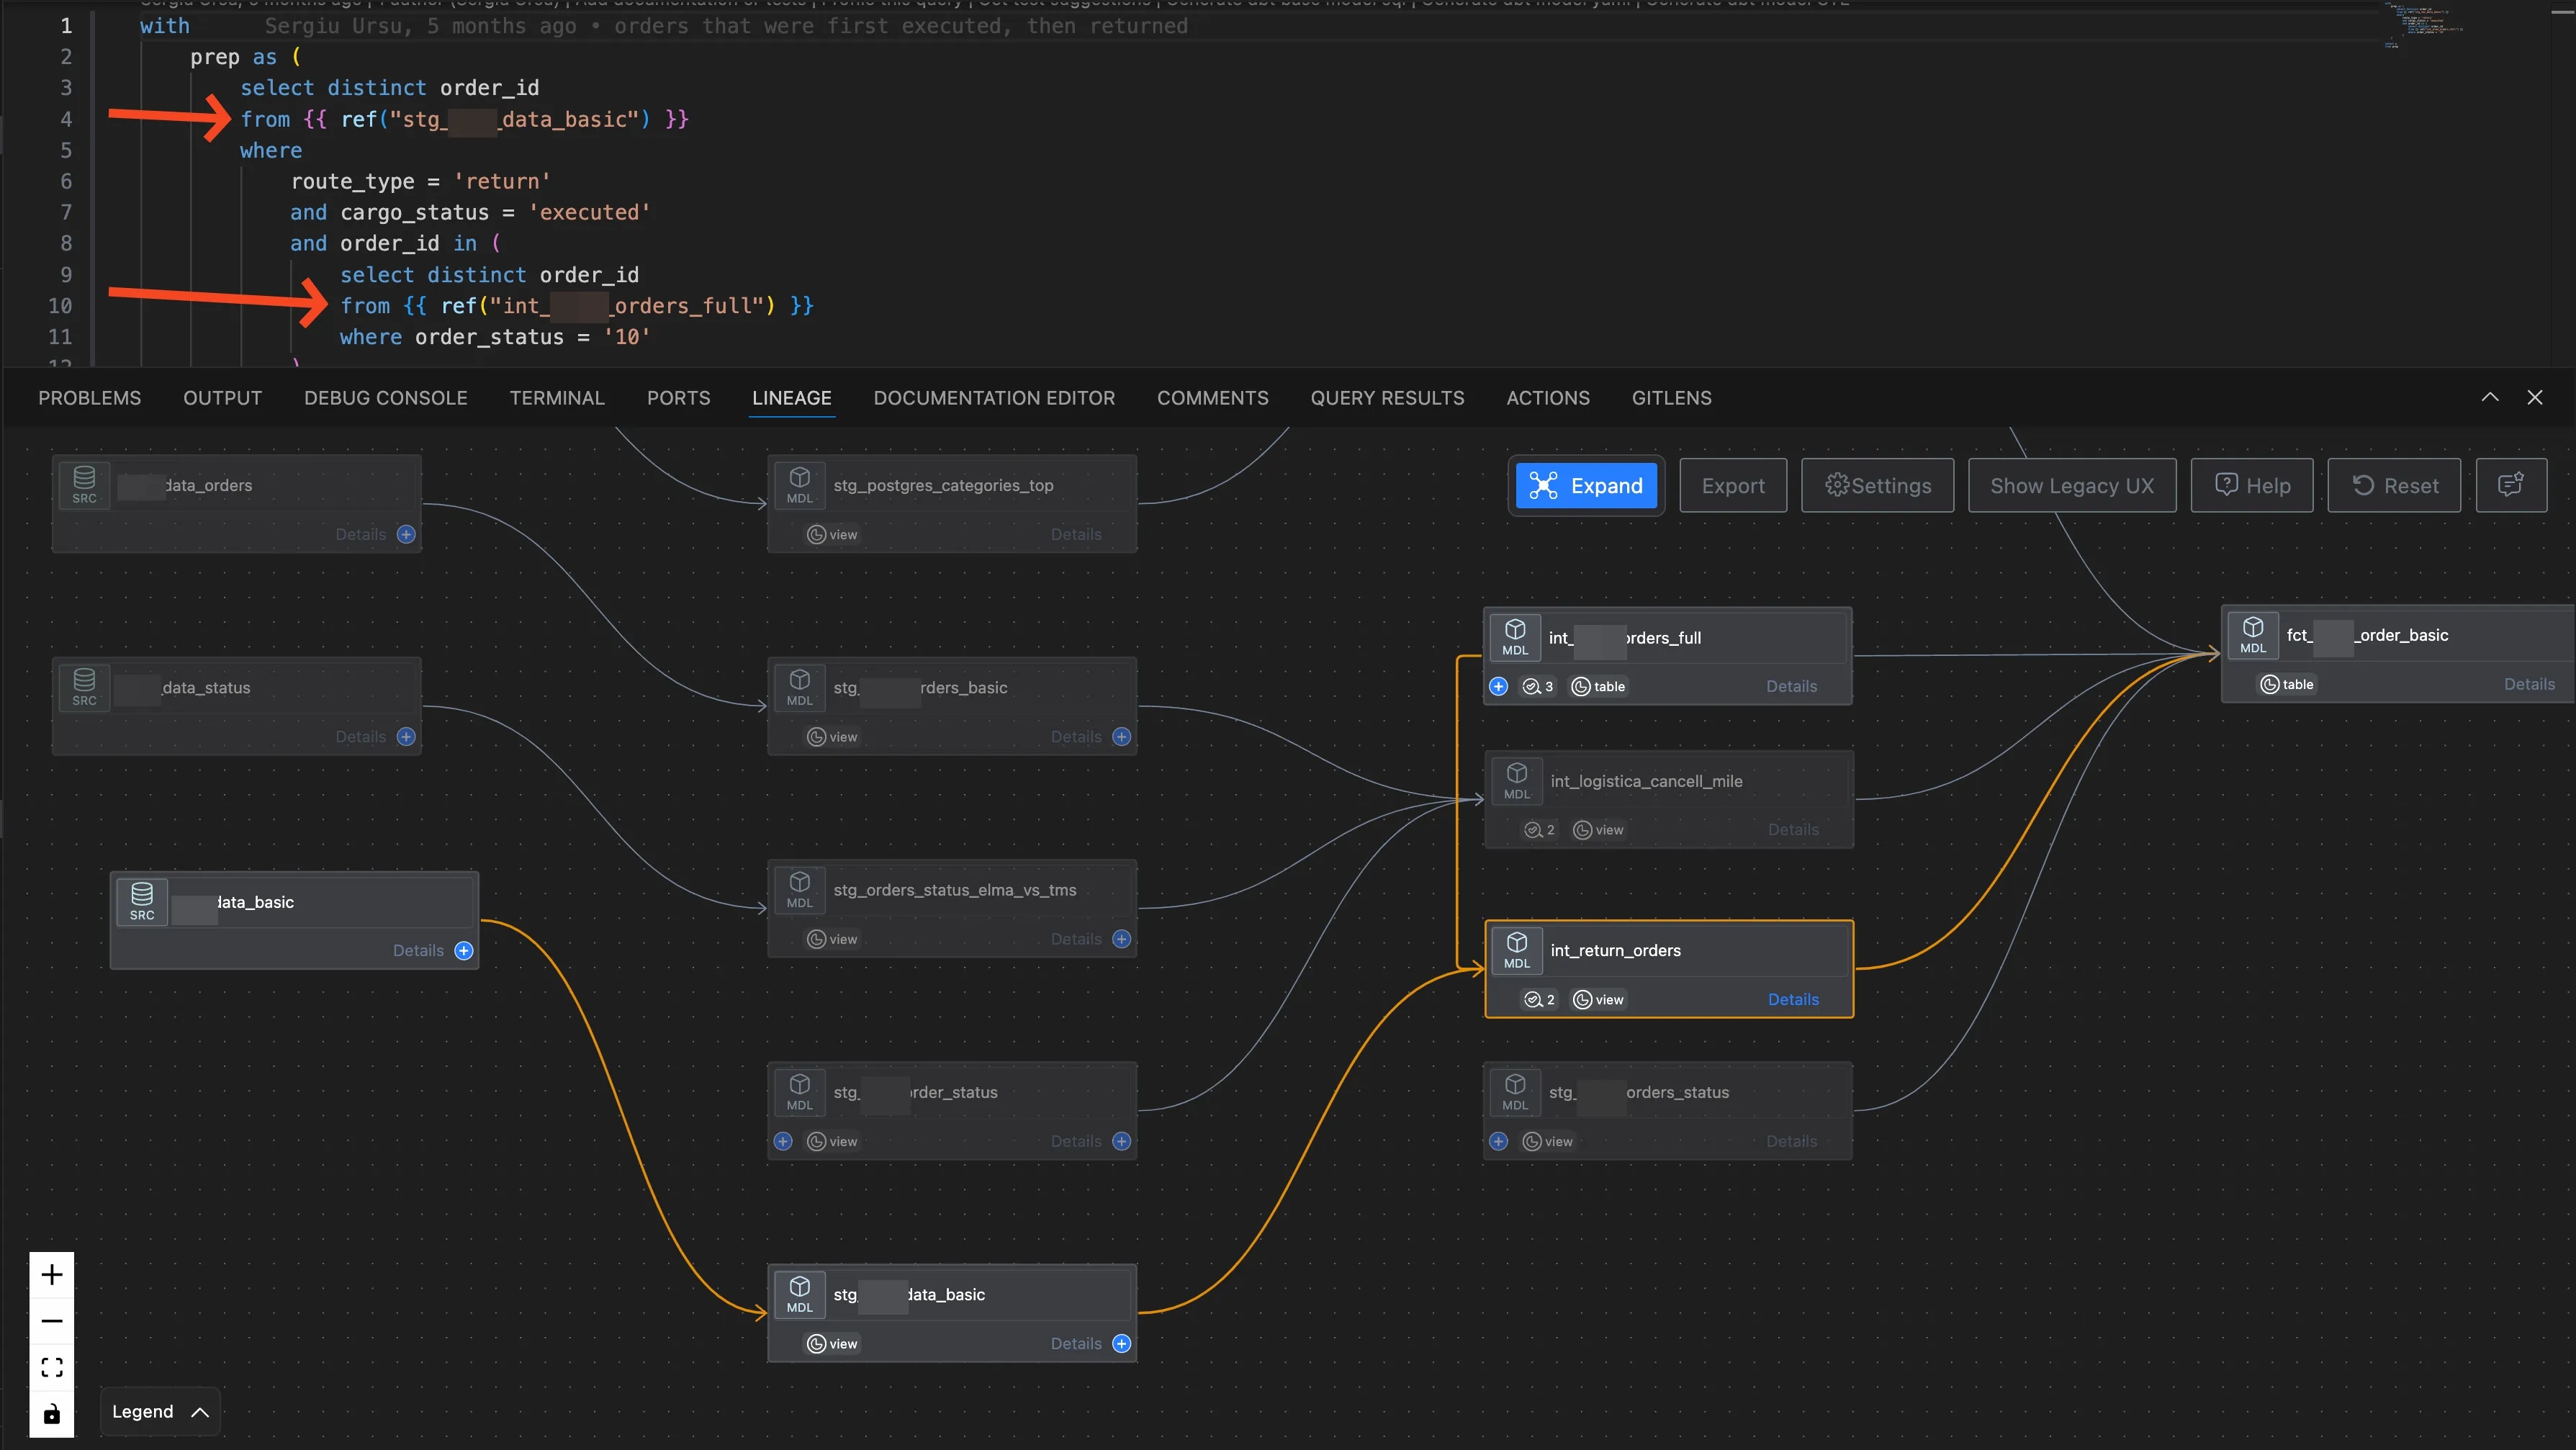
Для структурування даних і розуміння архітектури проєкту у DBT використовується функція {{ref}}. Замість того, щоб звертатися безпосередньо до таблиць, вона посилається на їхні назви, вказані в метаданих. Завдяки цьому весь проєкт вибудовується в єдину систему, де чітко видно: звідки беруться дані, які залежності між ними та на що вони впливають. Це не просто зручність, а ключовий механізм, який допомагає зберегти порядок у даних і розуміти структуру всього проєкту. На скріншоті нижче показано, як прописуються ці залежності безпосередньо у запиті, а також як у Lineage (схема даних) наочно відображається весь ланцюжок таблиць і колонок у них.
Також у процесі знайомства з організацією проєкту в DBT ви розберетеся з таким важливим поняттям, як шари даних. Вони допомагають логічно розділяти роботу з даними та розуміти роль кожного етапу.
Основні шари в DBT:
Stage – це сирі, але вже трохи очищені та впорядковані дані, які проходять обробку після завантаження з зовнішніх джерел.
Intermediate – проміжний шар, де дані вже збагачені, нормалізовані та містять ключові виміри (Dimensions) і розрахункові метрики (Measures).
Mart – шар вітринних даних, де формуються фінальні моделі, призначені для кінцевих користувачів, BI-інструментів і дашбордів.
Розуміння призначення цих шарів допомагає чітко усвідомлювати, для чого потрібен кожен із них, які завдання він виконує і яку користь приносить. Це також спрощує підтримку проєкту та захищає дані від помилок на кожному етапі трансформації.
Контроль якості даних
Часто до обов’язків аналітика на проєкті входить, серед іншого, і контроль якості даних. Мало просто отримати дані та передати їх далі – їх необхідно попередньо очистити й обробити. Для цього в DBT є зручний функціонал – тести, які допомагають автоматично перевіряти дані на відповідність заданим вимогам. Причому є як вбудовані стандартні тести, так і можливість самостійно створювати складні кастомні тести.
Стандартні тести включають в себе такі перевірки, як NotNull (значення не повинно бути порожнім), унікальність, відповідність діапазону (значення більше або менше заданого порогу). Але при бажанні можна написати й більш складні тести, додаючи логіку та сценарії під конкретні вимоги бізнесу.
Тести можна прописувати прямо у .yml-файлі (див. скріншот нижче), вказуючи, які перевірки мають застосовуватися до певних колонок. Також можна створювати окремі тестові моделі, що перевіряють, наприклад, коректність метрик або аномалії в даних.
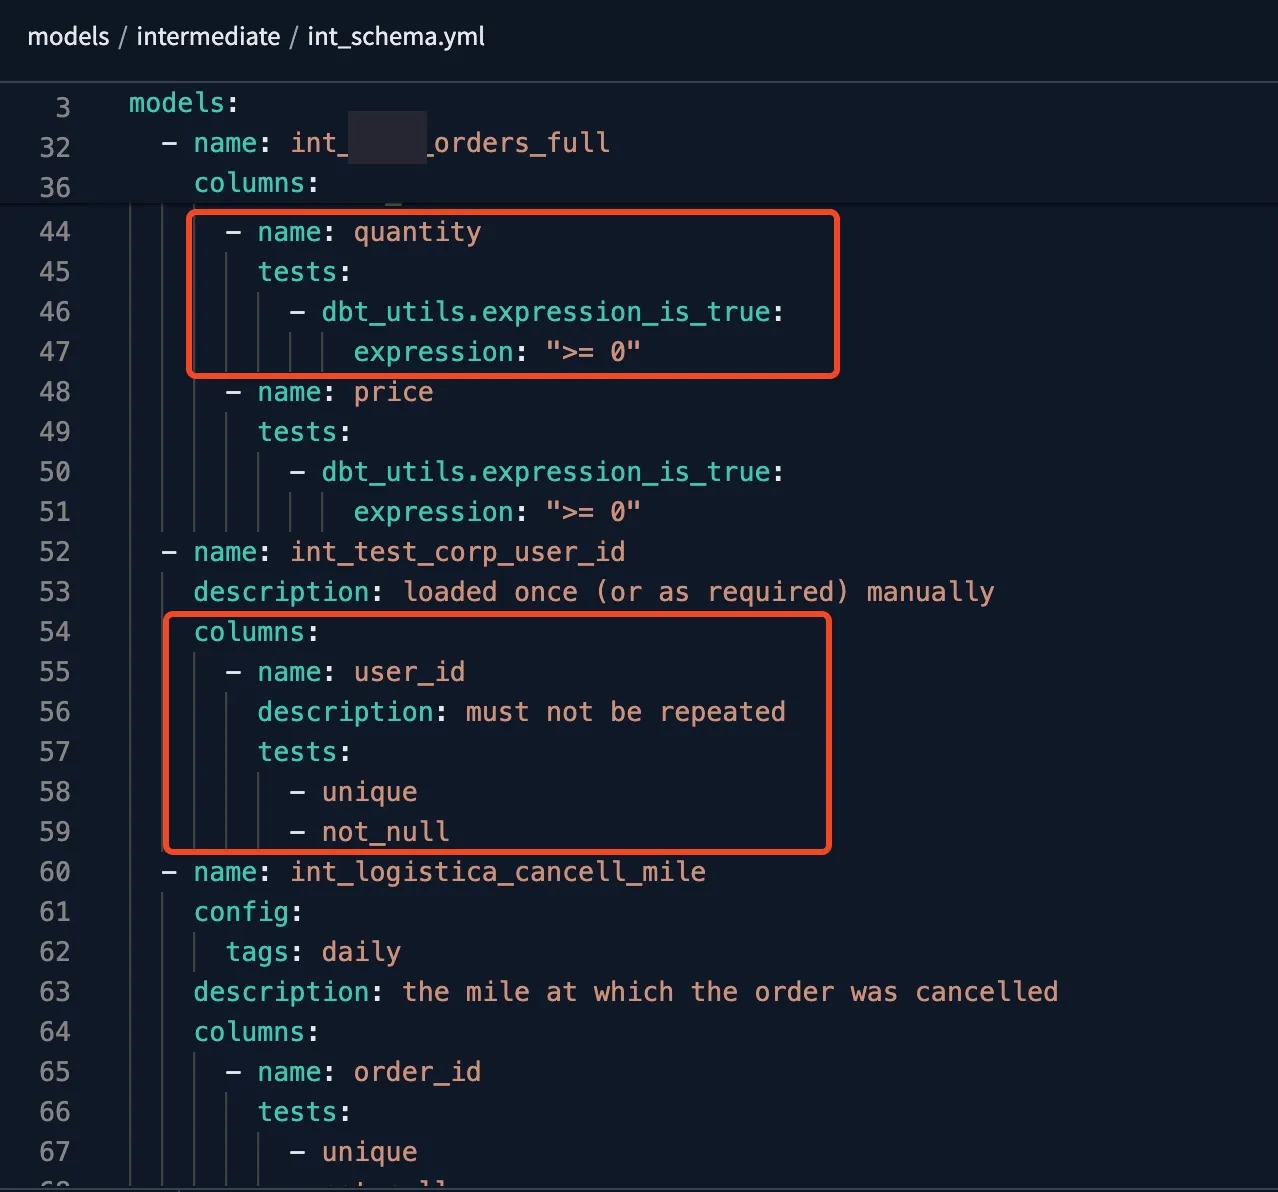
Я знову рекомендую починати з простого – наприклад, використовувати стандартні тести на унікальність або відповідність діапазону значень, прописуючи їх у .yml-файлі. Після того як ви розберетеся, як вони працюють і як тестувати їх у різних сценаріях, можна переходити до більш складних тестів. Вони прописуються окремими скриптами і зберігаються у папці з тестами, дозволяючи перевіряти більш складну бізнес-логіку даних.
До контролю якості даних також належить їх актуальність. У .yml-файлі, де описуються джерела даних, можна задати максимально допустимий вік даних. Якщо дані не відповідають цьому критерію, DBT видасть попередження або помилку (залежно від налаштувань). Це дозволяє контролювати актуальність і швидко реагувати, якщо дані застаріли або завантаження нових даних відбулося із затримкою.
Звісно, не варто перевантажувати проєкт тестами – важливо обмежитися ключовими перевірками, які справді є критичними. Якщо перевіряти абсолютно всі дані, це може привести до потоку нескінченних сповіщень, що лише ускладнить роботу. Я зазвичай застосовую стандартні тести на унікальність для результуючих таблиць, а також перевірку свіжості для джерел даних. Такий підхід допомагає контролювати цілісність і актуальність даних на базовому рівні. Просто майте на увазі, що DBT надає значно більше можливостей для тестування як самих даних, так і їхньої актуальності. Налаштування тестів зручно конфігуруються і відображаються у .yml-файлі, де їх завжди можна перевірити, скоригувати або додати нові правила перевірки за потреби.
Контроль версій скриптів
Пояснити цю перевагу фахівцю, який не знайомий із Git, може бути складно, тому, мабуть, краще провести аналогію з Google Tag Manager, з яким більшість читачів на “ти”. Згадайте, наскільки зручно в GTM відкотитися до попередньої версії контейнера, якщо потрібно зрозуміти, які зміни були внесені кілька днів, тижнів чи навіть місяців тому (див. скріншот нижче). Просто знаходите потрібну версію і повертаєтесь до неї без необхідності вручну відновлювати кожен крок.
Точно так само працює контроль версій у DBT через GitHub або GitLab. Кожен крок змін фіксується, і в будь-який момент можна переглянути історію, повернутися до потрібного стану, порівняти зміни або ознайомитися з коментарями до цих змін. Це дає гнучкість, безпеку і прозорість у роботі з кодом і даними.
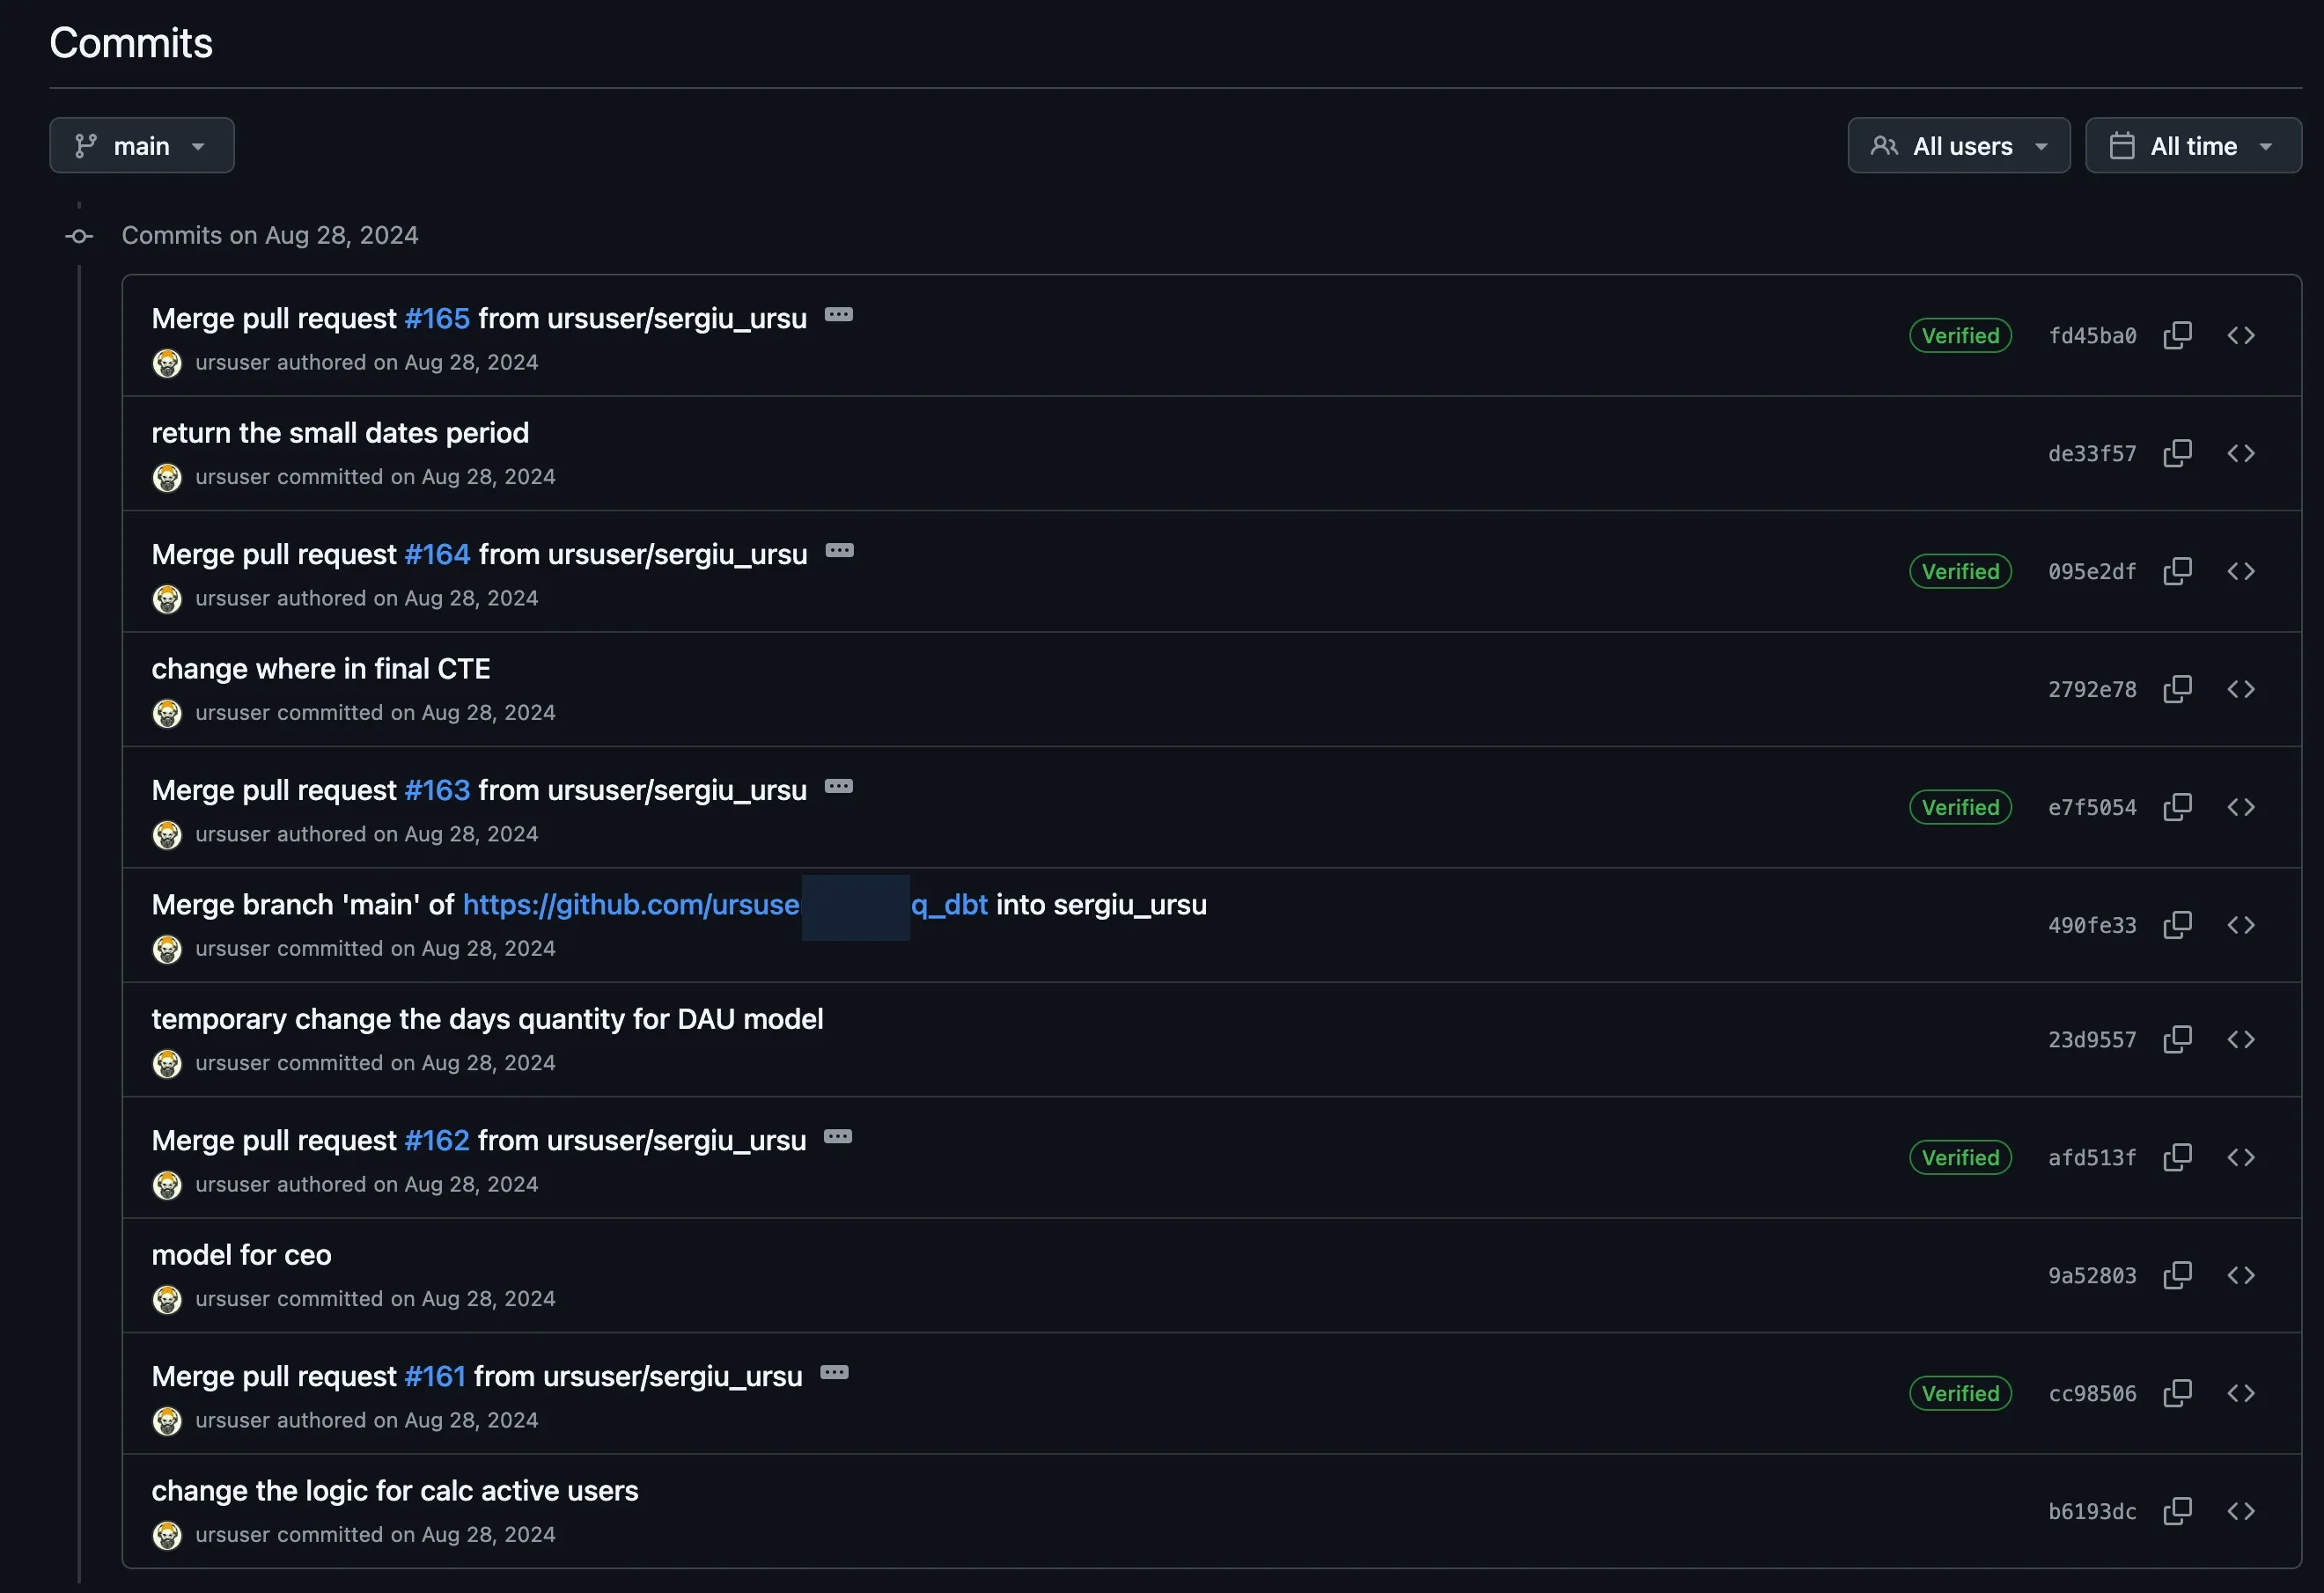
Навіть якщо ви працюєте над проєктом самостійно, я все одно рекомендую використовувати версії, гілки і Git-команди. Це не просто формальність, а корисна практика, яка дозволить вам розібратися в принципах роботи з Git і підготуватися до командної роботи. Коли в проєкті бере участь кілька аналітиків, кожен працює зі своєю гілкою, у своєму середовищі і зі своїми скриптами. Контроль версій допомагає уникати конфліктів, відстежувати зміни і керувати процесом розробки. Крім того, це дає уявлення про те, як організована робота аналітиків у великих компаніях, де процеси побудовані на спільній розробці і суворому контролі змін.
Ще одна важлива перевага роботи з різними гілками і середовищами – це можливість розділяти DEV і PROD середовища. Весь процес будується таким чином: попередні зміни вносяться в DEV, тестуються, відправляються в Git, а вже з Git потрапляють у PROD. Це дозволяє уникати помилок у проді, оскільки всі зміни проходять перевірку перед тим, як опинитися у бойовому середовищі. Такий підхід допомагає розуміти, як працювати безконфліктно, не зачіпаючи робочі скрипти і не порушуючи дані у продуктивному середовищі.
І тут виникає логічне питання: навіщо мені все це, якщо я працюю один? Якщо я фрилансер, у мене немає колег-аналітиків, немає команди на проєкті, то навіщо перейматися Git, версіями, середовищами і гілками? І відповідь тут проста: це знання, які вам, швидше за все, знадобляться у майбутньому, якщо ви плануєте розвиватися у напрямку дата-аналітики, дата-інженерії або у суміжних професіях. Подивіться вакансії на популярних сайтах і зверніть увагу на такі вимоги, як Git, DBT, робота з терміналом. Швидше за все, після цього у вас вже не виникне питання, навіщо вам це потрібно. І як тільки ви розберетеся у цьому процесі, він стане настільки логічним і природним, що важко буде уявити, як можна було працювати інакше. Ви почнете помічати, яких ризиків вдається уникнути, якщо дотримуватися правильної процедури: тестувати у DEV, фіксувати зміни у Git і тільки потім “виливати” їх у PROD. Робота стає структурованою, безпечною і передбачуваною, а сам процес — набагато зручнішим і прозорішим.
Оркестрація
Ну ось, ви написали всі свої 100500 скриптів (які, до речі, в DBT називаються моделями), розклали їх по папках, врахували всі шари – Stage, Intermediate, Mart, і все виглядає структуровано та логічно. Тепер настав час розібратися із їхнім запуском: як їх запускати за розкладом? У якій послідовності? Які скрипти повинні виконуватися першими? А які – тільки після оновлення певних даних? Для цього в DBT існують JOB-и (або іншими словами – оркестрація).
JOB-и в DBT мають максимальну гнучкість і можуть запускатися за різними параметрами. Їх можна налаштувати так, щоб вони працювали лише з певними папками чи ланцюжками моделей, запускали цілу папку, але виключали певні моделі, якщо їхнє виконання в конкретному сценарії не є необхідним.
Додатково можна використовувати теги, щоб згрупувати моделі за логікою і запускати їх у разі потреби. При цьому, що надзвичайно важливо, JOB враховує функцію {{ref}} всередині моделей і запускає їх у правильній послідовності. Він проходить по ланцюгу залежностей, починаючи з першої моделі, від якої залежать інші, і рухається до останньої. Це означає, що DBT не запустить проміжні моделі, якщо їхні вихідні дані ще не розраховані. Такий підхід гарантує цілісність даних і запобігає ситуаціям, коли у розрахунках використовуються неактуальні або незавершені дані.
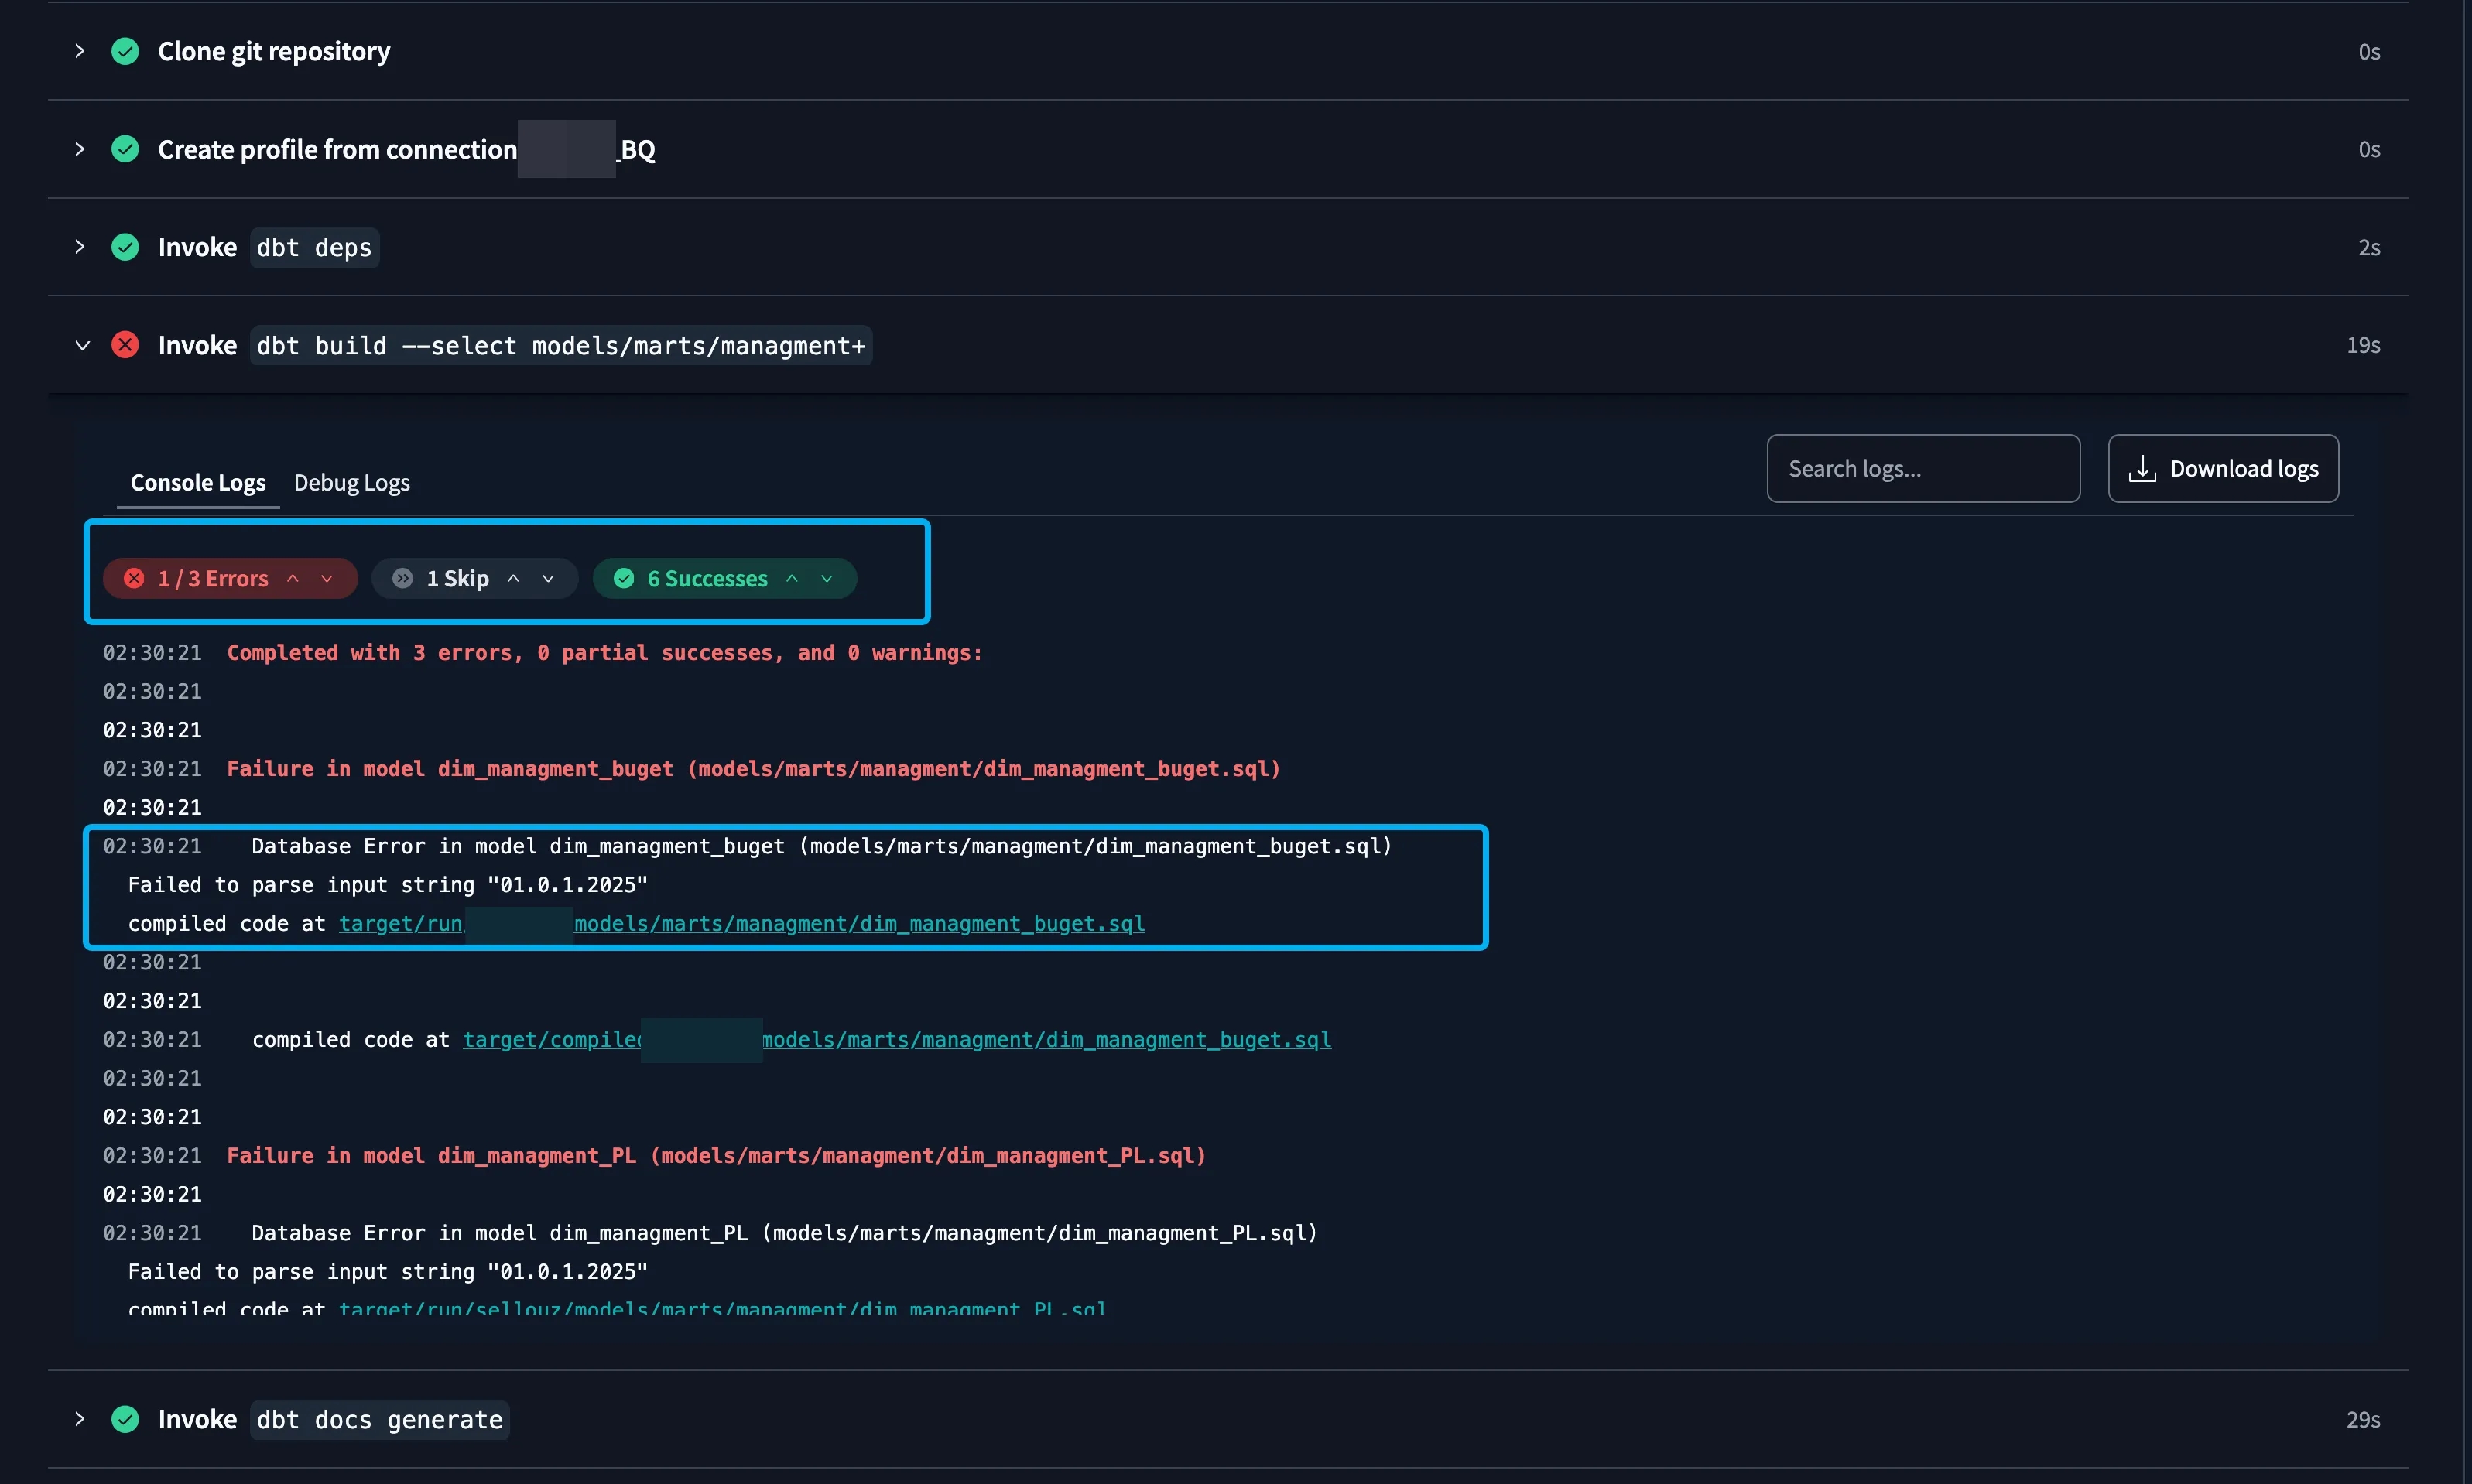
Ще один великий плюс JOB-ів – це логування. Якщо щось пішло не так, скрипт не запустився або виникла помилка, завжди можна переглянути лог, знайти проблему, виправити її і перезапустити процес. Це робить налагодження набагато зручнішим і дозволяє швидко реагувати на збої у пайплайні даних.
На скріншоті нижче зображено реальний сценарій із повсякденної роботи. Клієнт написав, що дані за вчора не оновилися і попросив розібратися. Все, що мені потрібно було зробити, – це зайти в потрібний JOB, відкрити його логування, переглянути помилки і відразу побачити, на якому рядку стався збій, чому скрипт не запустився і дані не оновилися.
У разі помилок під час виконання JOB-ів, можна налаштувати сповіщення на електронну пошту, що дозволяє оперативно дізнаватися про збої та негайно вживати заходів. Такий механізм повідомлень робить роботу більш надійною, оскільки ви не пропустите критичні помилки і зможете вчасно їх виправити, не чекаючи, поки хтось помітить проблему в даних. Це дуже зручно та корисно, особливо в продакшн-середовищі.
JOB у DBT виконує відразу кілька завдань. У заданий час він звертається до GitHub, завантажує актуальну версію коду, запускає її та підключається до бази даних. Потім він створює або оновлює таблиці, формуючи нові дані в проді, а також генерує документацію (що особливо важливо для великих проєктів!), яка враховує всі внесені зміни.
Документація (див. наступний скріншот) у DBT формується у вигляді інтерактивного сайту з клікабельними елементами. Можна переходити між моделями, таблицями, налаштуваннями, рівнями даних, а також переглядати взаємозв’язки, скрипти та тести. Уся структура проєкту стає прозорою та зрозумілою, а головне — цю документацію можна просто передати клієнту за посиланням, щоб він сам розібрався, як побудовано його проєкт.

При цьому весь процес логується, тож завжди можна відстежити, які етапи виконання пройшли успішно, де виникли помилки і що саме відбувалося під час оновлення даних. Ну хіба не магія!?
Потужна навчальна платформа
Що ж, припустимо, я переконав вас розібратися в DBT – зрозуміти, як він працює, які у нього можливості, які переваги і чим цей інструмент може бути корисним саме для вас. Тоді виникає логічне питання: де цьому навчитися? Які ресурси допоможуть розібратися в основах DBT, з чого краще почати його вивчення, щоб швидко зануритися в логіку роботи інструмента?
І знову ж таки, одна з великих переваг DBT – це обширна навчальна база. Існує безліч курсів, статей, документації, покрокових туторіалів і відеоматеріалів, які детально пояснюють, як працювати з DBT у різних системах і з різними базами даних. Є готові інструкції з підключення, розбір різних функцій, приклади використання від найрізноманітніших спеціалістів, що робить процес навчання максимально доступним і зрозумілим. Незалежно від вашого рівня досвіду, ви завжди знайдете ресурси, які допоможуть вам освоїти DBT.
Ось сторінка з усіма курсами по DBT, створеними розробниками інструмента і його офіційними представниками. На цьому ресурсі можна вибрати свою базу даних, етап розробки і рівень знань, що допоможе вам швидше адаптуватися до інструмента.
Я рекомендую почати з "DBT Fundamentals" – базового курсу, який пояснює основні принципи роботи з DBT. Після цього можна перейти до вивчення своєї бази даних і спробувати налаштувати невеликі моделі у тестовому проєкті, щоб закріпити знання на практиці.
Також у DBT є величезна спільнота, де обговорюються найкращі рішення, розбираються складні кейси і ведуться дискусії на актуальні теми. Існує форум DBT, де можна знайти відповіді на популярні запитання, а також Telegram-канали, Slack-спільнота і Discord-групи, де фахівці обмінюються досвідом, діляться новими фішками і допомагають один одному вирішувати складні завдання. Це цілий світ спеціалістів, які активно використовують DBT у своїй роботі і готові підказати, показати, як вони вирішували схожі проблеми. Тому, якщо у вас виникнуть питання або захочеться дізнатися про передові практики DBT, ви завжди зможете знайти відповідь на своє запитання. Тут головне – бажання, а ресурсів достатньо, щоб вивчити цей інструмент.
Ну що ж, хотілося б сказати, що це все, про що я збирався розповісти. Але, пробігшись очима ще раз по статті, розумію, що далеко не все встиг охопити. Насправді, матеріалу вже вистачить на невелику книгу, і якщо заглиблюватися далі, то стаття стане нескінченною. Тому зупинюся на цьому етапі, а пропущену частину можливостей та інструментів залишу вам для самостійного вивчення.
Я не встиг розповісти про макроси, сіди, різні матеріалізації таблиць, семантичний шар, мову Jinja, пакети і багато-багато іншого. Але вся ця інформація доступна на сторінці курсів, де кожна з цих тем розібрана окремо, тож у вас завжди є можливість заглибитися в неї і знайти відповідь на своє запитання.
Мені залишається лише побажати вам успіхів у вивченні DBT і позаздрити тому новому горизонту знань, який перед вами відкриється. Дуже сподіваюся, що це стане наступною сходинкою у вашому розвитку як аналітика, спрямовуючи вас у бік дата-інженерії та глибшого розуміння принципів роботи з даними.
Завантаження коментарів…