- Головна
- /
- Архів розсилок
- /
- Дайджест з вебаналітики #66
від 11 Вересня 2026р.
від 11 Вересня 2026р.
Привіт 🙌
Сьогодні, як завжди, на тебе чекає багато корисного. Але почну я з двох, на мою думку, найважливіших новин на зараз.
📱 Це нарешті сталося: анонсую курс з аналітики мобільних додатків!
Перш за все хочу повідомити: ти нарешті дочекався/лась 🙂
На цю тему було багато мемів, ще більше обговорень і купа жартів у наших чатах. Але так чи інакше, час настав — я анонсую курс з аналітики мобільних додатків. І, звісно, ти дізнаєшся про це серед перших.
Вчора я опублікував у Facebook пост із попередньою програмою курсу. Вона ще буде уточнюватися та доповнюватися, але вже зараз можна побачити, які теми планую розбирати.
А тепер поділюся ще однією деталлю, про яку поки що не писав у Facebook. Наразі ця інформація — тільки для підписників розсилки:
Доступ всім Early Birds буде відкрито одночасно. А через кілька тижнів проведемо спільну онлайн-зустріч, де ти зможеш поставити мені свої запитання, обговорити матеріали курсу та поспілкуватися з іншими учасниками. Така собі невелика тусовка для першого набору 🙂
Якщо у тебе немає Facebook, але ти хочеш на курс, просто напиши мені у відповідь на цей лист.
А поки я готую курс з мобільної аналітики саме час закрити всі запитання з аналітики сайтів. І тут вже є конкретні дати і цифри.
17 потік курсу PRO ANALYTICS запускається вже через два тижні. На тебе чекає 10 тижнів інтенсивного навчання:
Новий потік стартує вже 28 вересня, і все це чекає тебе.
👉 Переглянути програму та записатися на PRO ANALYTICS >>>
Анонси курсів це важливо, але на тебе сьогодні чекає ще багато іншого.
1. Наші матеріали та новини:
🔸 GA4 і GTM уже недостатньо: які інструменти потрібні СУЧАСНІЙ маркетинговій команді.
2. Новини Google BigQuery:
🔹 TabFM у BigQuery: прогнозування без навчання власної ML-моделі. (Preview)
🔹 Автоінкрементні колонки-ідентифікатори в BigQuery. (Preview)
🔹 Підтримка аналізу ринкового кошика в Conversational Analytics.
🔹 Запитання для прогнозного моделювання через AI.PREDICT в Conversational Analytics. (Preview)
🔹 Новий розділ Monitoring у Conversational Analytics. (Preview)
🔹 Пайплайни в Git-папках. (Preview)
🔹 BigQuery Graph став загальнодоступним.
🔹 Data Engineering Agent тепер підтримує HIPAA compliance.
🔹 Generative AI functions у BigQuery тепер підтримують ще три Flash-моделі Gemini.
3. Інші новини:
🔹 ЄС офіційно визнав ChatGPT дуже великою пошуковою системою.
🔹 Google Search Console отримала звіти про видимість сайтів у AI-пошуку.
🔹 Search Console тепер показує, як твій контент із соцмереж знаходять у Google.
4. Корисні матеріали (у цьому випуску — інструменти):
Я, як завжди, займаюся купою справ одночасно. Наскільки ефективно це в мене виходить — уже інше питання, але упустимо його :)
Крім запису нового курсу та підготовки до старту PRO ANALYTICS, я ще встиг написати нову статтю для блогу ProAnalytics Team — про те, які інструменти потрібні сучасній маркетинговій команді.
У ній я розібрав, чому сьогодні для повноцінної маркетингової аналітики вже недостатньо лише GA4 та GTM, а також як поєднати дані із сайту, CRM, рекламних платформ і внутрішніх систем в одну зрозумілу систему.
Статтю можна використати як невелику перевірку: подивитися на всю систему цілком і зрозуміти, з якими її частинами ти вже добре знайомий, а з якими ще варто розібратися. Ну і якщо десь знань не вистачає - курсі PRO ANALYTICS я якраз розбираю значну частину цього набору.
👉 Перевірити, чи всі інструменти сучасної маркетингової аналітики вже є у твоєму арсеналі >>>
А якщо ти прочитаєш статтю і зрозумієш, що вже все це знаєш, — чудово. Тоді перешли її своєму другу-маркетологу. Можеш навіть додати, що незабаром стартує PRO ANALYTICS :)
Я взагалі вважаю, що цей матеріал варто роздрукувати й покласти на стіл кожному маркетологу. Ну або хоча б зберегти, щоб не загубити - тому думаю він буде тобі дуже вдячний.
Якщо подивитися на нашу класичну четвірку — GA4, GTM, BigQuery та Power BI, — цього разу апдейтами нас порадував лише BigQuery. Але є й інші важливі оновлення поза цим набором, які безпосередньо впливають на нашу роботу. Тому давай розбиратися.
Цього разу я вирішив скласти невеликий рейтинг оновлень. І почнемо, на мою думку, з найважливішого.
🚩 1 місце. TabFM у BigQuery: прогнозування без навчання власної ML-моделі. (Preview)
BigQuery тепер підтримує TabFM — попередньо навчену фундаментальну модель Google для роботи з табличними даними. Вона дозволяє виконувати дві класичні задачі машинного навчання:
І найцікавіше тут те, що модель не потрібно окремо навчати та налаштовувати під свій датасет у традиційному розумінні. Ти передаєш їй історичні дані з відомими результатами та таблицю, для якої потрібно зробити прогноз, а TabFM аналізує ці приклади без окремого циклу навчання і розгортання моделі.
Зазвичай, коли ми створюємо ML-модель під конкретне завдання клієнта, саме її навчання та налаштування можуть бути одними з найбільш ресурсозатратних етапів. Це потребує часу, обчислювальних ресурсів і, відповідно, грошей.
Google пропонує інший підхід: уже навчену модель, яка потенційно може закривати багато задач із прогнозування на структурованих даних без необхідності щоразу проходити весь цей процес із нуля.
Звучить звісно добре, але завжди треба дивитися, наскільки добре вона працюватиме на реальних бізнес-задачах і конкретних наборах даних.
👉 Дізнатися, як TabFM працює в BigQuery та для яких задач її можна використовувати >>>
🚩 2 місце. Автоінкрементні колонки-ідентифікатори в BigQuery (Preview)
Чесно кажучи, кому віддати друге місце, вирішити було складніше, оскільки є ще три важливі новини. Але нехай це буде можливість, якої BigQuery досить довго не вистачало.
Тепер у таблицях можна створювати identity columns — колонки з автоматично згенерованими числовими ідентифікаторами.
Це досить класична можливість для баз даних: якщо під час додавання нового рядка не передати власне значення ідентифікатора, BigQuery згенерує для нього унікальний INT64. Такі колонки можна використовувати, зокрема, для створення та підтримки первинних ключів. Водночас варто пам’ятати, що обмеження первинного ключа в BigQuery не перевіряються автоматично, як мінімум на момент написання матеріалу.
Звісно, автоінкрементний ідентифікатор потрібен далеко не для кожної задачі. Але загалом це базова й корисна можливість, якої в BigQuery часто не вистачало.
👉 Подивитися, як створювати та використовувати identity columns у BigQuery >>>
🚩 3 місце. Три важливі оновлення Conversational Analytics
Третє місце віддаю оновленням Conversational Analytics.
І причин для цього дві.
По-перше, самі оновлення справді гарні. А по-друге, нагадую, що до 30 вересня 2026 року ти ще можеш тестувати Conversational Analytics без оплати за використані токени. (При цьому стандартна плата за обробку запитів у BigQuery залишається).
Тому, якщо давно хотів потестити цей функціонал, але все відкладав, — часу залишилося небагато (тут детальна інструкція від мене з покрокового налаштування). А тепер до оновлень:
Фактично це класична задача «що з чим купують»: аналіз допомагає знайти товари, які часто купують разом, і зрозуміти, які з них варто об’єднувати в набори або використовувати для перехресних продажів.
Тепер ти можеш просто прийти в чат і поставити, наприклад, таке запитання:
«Які товари варто об’єднати в набори на основі даних за 2026 рік?»
Conversational Analytics самостійно використовує вбудовані SQL-шаблони та повертає результати з основними показниками аналізу асоціативних правил.
Детальніше про аналіз ринкового кошика в Conversational Analytics >>>
Тобто ти можеш сформулювати задачу природною мовою, а агент застосує AI.PREDICT, щоб виконати класифікацію або регресію на основі твоїх даних без окремого навчання власної моделі.
Спочатку його потрібно активувати для свого Google Cloud-проєкту. Після цього ти зможеш відстежувати:
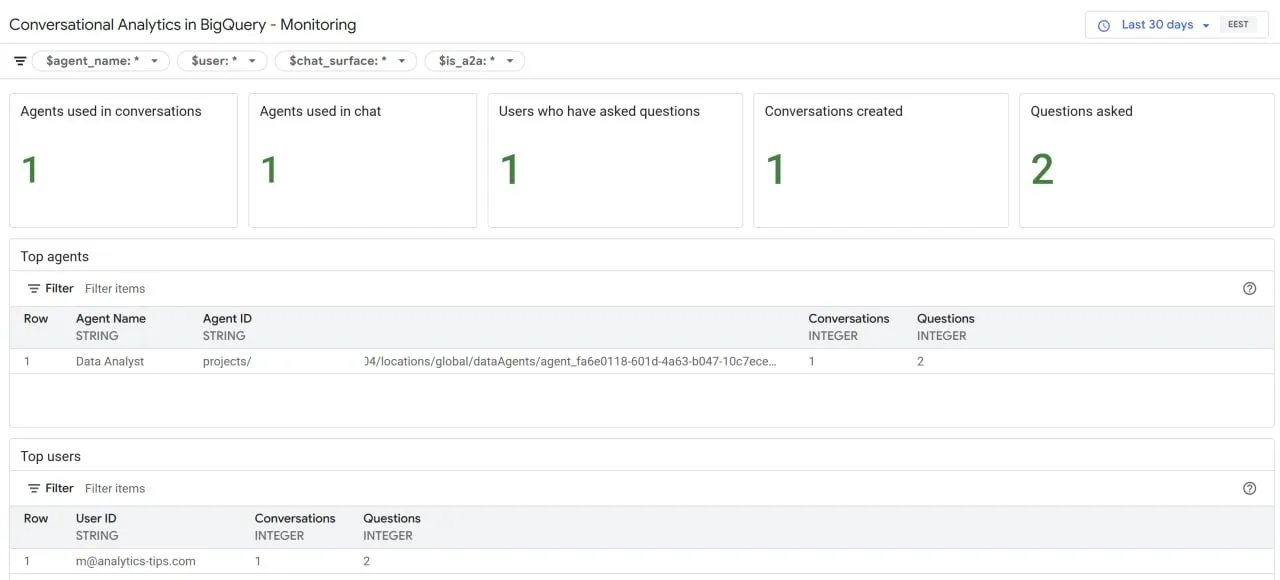
Окремо можна подивитися, які джерела знань найчастіше використовуються для пошуку відповідей. Тобто фактично побачити, до яких таблиць Conversational Analytics звертається під час роботи з питаннями користувачів.
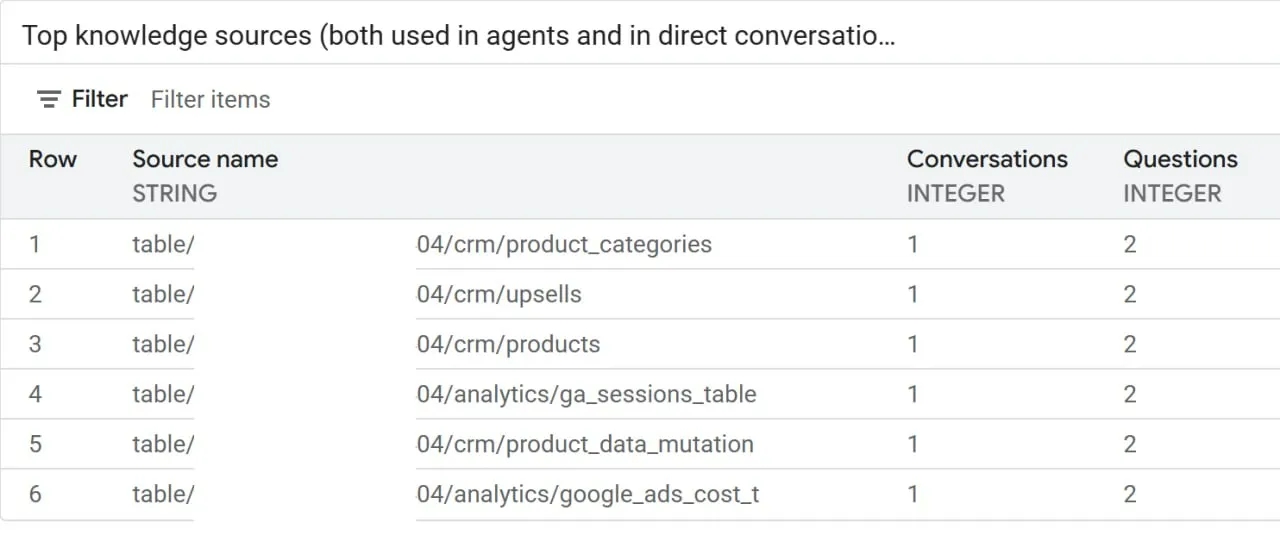
Ну і окреме ВАУ, що статистика з’являється практично в реальному часі.
Як результат, маємо зручний спосіб зрозуміти, як люди реально використовують дата агента.
Детальніше про можливості Conversational Analytics у BigQuery >>>
🚩 Пайплайни в Git-папках у BigQuery. (Preview)
Ще одна новина, яку я теж вважаю дуже важливою, але яка, на жаль, не потрапила до мого суб’єктивного топу. Тепер у BigQuery можна створювати, зберігати та керувати пайплайнами безпосередньо в Git-папках.
Відповідно, для пайплайнів стають доступними контроль версій, історія змін, зручніша командна робота та інші переваги Git. Загалом це важливий крок до більш системної роботи з пайплайнами в BigQuery — особливо якщо над ними працює не одна людина, а ціла команда.
👉 Дізнатися, як створювати пайплайни в Git-папках та керувати ними в BigQuery >>>
Ну і коротко про інші новини BigQuery, які можуть бути корисними в окремих специфічних кейсах:
🚩 BigQuery Graph став загальнодоступним, але для основних графових обчислень потрібне резервування рівня Enterprise або Enterprise Plus. Користувачі, яким раніше надали доступ за списком дозволених, зможуть працювати зі Standard edition або оплатою за обсяг оброблених даних до 26 квітня 2027 року.
🚩 Data Engineering Agent тепер підтримує HIPAA compliance — якщо ти працюєш із медичними даними на американському ринку, це оновлення може бути для тебе особливо важливим.
🚩 Generative AI functions у BigQuery тепер підтримують ще три Flash-моделі Gemini: gemini-3.5-flash-lite, gemini-3.6-flash і gemini-3.7-flash.
31 серпня Європейська комісія надала ChatGPT статус Very Large Online Search Engine (VLOSE) відповідно до Digital Services Act.
Підставою стала кількість користувачів: ChatGPT має 159,1 мільйона середньомісячних активних користувачів у Європейському Союзі, тоді як поріг для отримання такого статусу становить 45 мільйонів.
Після цього рішення OpenAI має до січня 2027 року виконати додаткові вимоги DSA. Компанія повинна, зокрема, оцінювати ризики, пов’язані з роботою сервісу та його алгоритмів, і впроваджувати заходи для їх зменшення.
Ця новина фактично підтверджує те, що вже відбувається з нашими звичками: ChatGPT поступово стає ще одним повноцінним способом шукати інформацію. Особисто я зараз уже приблизно порівну "гуглю" щось в Google і приблизно стільки ж шукаю через LLM. При цьому з особистими питаннями частіше йду в ChatGPT, а з робочими — поки що Google залишається фаворитом.
Причина доволі проста: під час робочого пошуку я зазвичай очікую побачити знайомі сайти, медіа або авторів, яким уже довіряю. І, думаю, я точно не один такий. Саме тому, на мою думку, роль бренду в пошуку буде тільки зростати.
Неважливо, де саме людина отримає відповідь — у Google, ChatGPT чи іншому AI-сервісі. Якщо вона впізнає джерело й уже довіряє йому, це може суттєво вплинути на те, чи сприйме вона інформацію серйозно і чи захоче перейти далі.
Тому робота з брендом поступово стає важливою не лише для класичного пошуку, а й для того, як компанію або автора знаходитимуть через AI-інструменти. І це, на мою думку, впливатиме на подальший розвиток SEO та контент-маркетингу.
І якраз для того, щоб хоч якось оцінювати все, що зараз відбувається навколо AI-пошуку, у Google Search Console з’явився новий Generative AI performance report.
31 серпня Google завершив глобальне розгортання цього звіту, тому тепер він доступний для всіх сайтів. У нових звітах можна побачити:
Як на мене, це хороший початок, але поки що картина дуже неповна. Головна проблема — у звітах є покази, але немає кліків. Тобто ми бачимо, що сторінка з’явилася в генеративній видачі, але не можемо зрозуміти, чи перейшов із неї хтось на сайт і який реальний трафік вона принесла.
Тож сам факт появи окремого звіту — це класно. Але тепер дуже хотілося б побачити продовження.
Паралельно в Search Console з’явився перемикач Search generative AI control. За його допомогою ти можеш дозволити або заборонити використання посилань і контенту сайту в генеративних функціях Google Search. Але тут усе досить радикально: якщо виключити сайт, він не отримуватиме з цих функцій ані показів, ані трафіку.
Тобто тепер контент у соцмережах можна оцінювати не лише за внутрішньою статистикою самих платформ, а й з погляду його видимості в екосистемі Google.
👉 Дізнатися, як працюють platform properties у Search Console >>>
Хоча сьогодні правильніше було б назвати цей блок корисними інструментами.
За останній тиждень одразу двоє хороших аналітиків порекомендували мені OpenReplay — безкоштовну open source альтернативу Hotjar і FullStory.
Звісно, думаю, багато хто уже використовує безкоштовний Microsoft Clarity.
Але якщо можливостей Clarity тобі не вистачає, а грошей на Hotjar чи FullStory немає — бо, чесно кажучи, це доволі дороге задоволення, — OpenReplay може стати цікавим варіантом.
Його можна розгорнути на власній інфраструктурі й отримати записи сесій, теплові карти та багато іншого корисного. Сам OpenReplay безкоштовний, але варто врахувати витрати на інфраструктуру та ресурси для налаштування.
Переглянути можливості OpenReplay і варіанти розгортання >>>
Не міг завершити цю розсилку без ще однієї новини про AI — він зараз буквально скрізь. Але ця новина справді заслуговує на твою увагу.
Anthropic випустила Commerce Agents Blueprint — готову основу з кодом, інструментами та правилами, на базі якої компанії можуть створювати власних AI-агентів для торгівлі. В середині два основні агенти:
Мене особливо зацікавила саме друга частина про Merchant Agent. Наприклад, агент може помітити, що певний товар скоро закінчиться перед стартом акції, або запропонувати, на які товари варто дати знижку, щоб швидше продати залишки. При цьому остаточне рішення залишається за людиною — без її підтвердження зміни не застосовуються.
Звучить дуже цікаво, хоча до повноцінного тестування ми поки що не дісталися. Якщо захочеш спробувати раніше за нас, Anthropic опублікувала і докладний опис рішення, і сам код.
Розібратися, як працюють Commerce Agents від Anthropic >>>
Переглянути код Commerce Agents Blueprint на GitHub >>>
До зустрічі в наступних розсилках!
Будь в курсі актуальних новин зі світу аналітики!
