Згідно з довідкою, Pipe query syntax (далі – Pipe) – це розширення мови запитів SQL, яке є простішим і лаконічнішим, ніж стандартний синтаксис SQL. Pipe підтримує ті самі операції, що й стандартний синтаксис, і покращує деякі області функціональності та зручності використання запитів SQL. Перед тим, як “винайти” Pipe, Google провів дослідження і дуже детально описав його тут. Наступний скріншот як раз з цього дослідження. Він наглядно відображає заплутану логіку виконання звичайного SQL запиту і який лінійний і логічний вигляд цей запит має на Pipe.
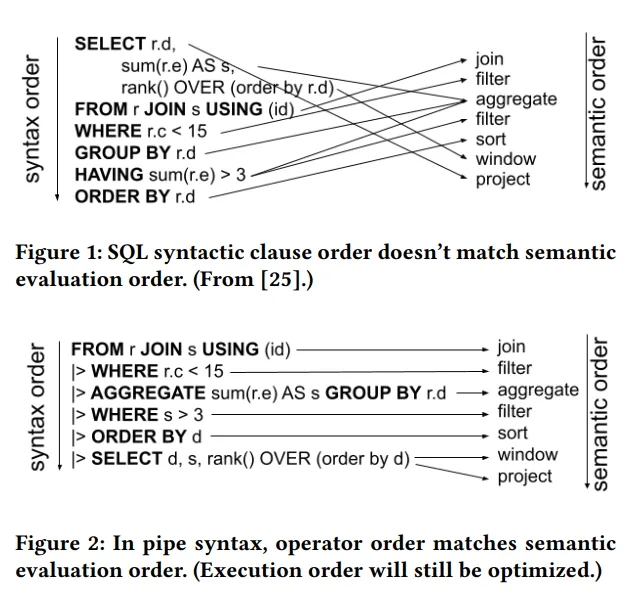
Якщо ви схожі на мене, то попередня інформація вас не дуже вразила…
Я вважаю себе доволі скептичною людиною, яка не любить зміни. Тому перше, про що я подумала, коли побачила перші згадки про Pipe: "ну от для чого придумувати велосипед? Сіквел же і так найпростіша мова програмування."
А ще я – людина, яка любить мати свою аргументовану думку. Тому ледь не перше, що я зробила, коли Pipe став загальнодоступним,- пішла в ньому розбиратись, щоб впевнитись, що Google придумав фігню. Мого скепсису вистачило десь на годину. Неочікувано для себе я зрозуміла, що цей синтаксис потрапив в саме серденько. Але про все, як завжди, по порядку:
Структура та мета статті
Я не буду описувати довідку. Натомість я поділюсь прикладами запитів різної складності на основі сирих даних GA4 в двох варіантах написання – стандартний SQL і Pipe. І на цих прикладах ми розберемо відмінності, щоб ви самі для себе вирішили, що краще – новий синтаксис або вічна класика. Хоча можливо “вічна” треба б заключити в лапки…
Запит 1 – ТОП-10 джерел користувачів
Почнемо з простого – визначимо 10 джерел, які приводять на ваш сайт найбільше користувачів.
| SQL | Pipe |
|---|
-- вибери
SELECT
-- перше джерело і перший канал залучення
traffic_source.source,
traffic_source.medium,
-- порахуй кількість користувачів
COUNT(DISTINCT user_pseudo_id) AS users
-- з даних екпорту GA4
FROM bigqueryfortests.analytics_11111111.events_20*
-- і згрупуй користувачів по джерелу і каналу
GROUP BY 1, 2
-- потім відсортуй по кількості користувачів в спадному порядку
ORDER BY users DESC
-- і виведи 10 значень
LIMIT 10
| -- з даних екпорту GA4 FROM bigqueryfortests.analytics_11111111.events_20*
-- порахуй кількість користувачів
|>AGGREGATE
COUNT(DISTINCT user_pseudo_id) AS users
-- в розрізі першого джерела і каналу залучення
GROUP BY
traffic_source.source,
traffic_source.medium -- потім відсортуй по кількості користувачів в спадному порядку
|>ORDER BY users DESC -- і виведи 10 значень
|>LIMIT 10 |
Я додала “переклад людською мовою” в коментарях до кожного рядка запиту навмисно. Сам синтаксис, звісно, відрізняється, але візуально не сильно видно, в чому “профіт”. Ви можете сказати: “я добре знаю SQL, тоді для чого мені витрачати час на те, щоб розібратись з Pipe?” Я була саме такої думки. Але спробуйте прочитати тільки коментарі і відповісти собі на питання: “де читається легше?..”
Опис основних операторів
Можливо, ви помітили, а, можливо, ні, але в попередньому запиті на Pipe немає оператора SELECT. Для SQL обов’язковими є 2 оператора – SELECT і FROM. Для Pipe такий тільки один – FROM. Фактично SELECT * FROM table на Pipe буде просто – FROM table.
SELECT в свою чергу втратив свою обов’язковість і зрівнявся за “рейтингом” зі всіма іншими операторами.
Серед тих, які ви будете використовувати найчастіше, наступні:
- |>AGGREGATE – забирає на себе функцію агрегації, яка раніше виконувалась в SELECT. Використовується разом з GROUP BY, щоб задати параметри, для яких виконується агрегація.
- |>SELECT – використовується для переліку колонок, які треба взяти з таблиці. Може також перейменовувати поточні колонки та додавати нові через прості операції без агрегування, наприклад,
x * y AS z. Але не раджу додавати нові колонки в цьому операторі, бо для цього є наступний оператор. Єдине, для чого я можу ще використати SELECT, окрім його прямої задачі, це перейменувати пару колонок, хоча для цього є RENAME. Але якщо перейменувати треба багато чого, краще використати відповідний оператор. - |>EXTEND – використовується для додавання нових колонок на основі існуючих. Так, їх можна додати і в SELECT, але великий плюс Pipe заключається в його читабельності – використовуйте його оператори за логічним призначенням, тоді ви зможете по ним швидко визначити хід обробки даних – де ми просто вибираємо колонки, а де додаємо нові. Якщо робити це все “за класикою SQL” в SELECT, це швидко ускладнить вам життя.
- |>SET – на відміну від попередньої функції, не додає нові колонки, а модифікує існуючі. Принцип як у
SELECT * REPLACE (column * 2 AS column). При цьому синтаксис інший, але теж логічніший – назва_колонки = вираз: |>SET column = column * 2
- |>WHERE – об’єднує в собі WHERE, HAVING і QUALIFY. Так, тепер для фільтрації не треба думати, що використати з цих трьох операторів. Треба щось відфільтрувати? Це робота для WHERE.
- |>JOIN – робить все те саме, що і зазвичай – об’єднує таблиці.
- |>UNION – теж робить те ж, що й завжди – додає до першої таблиці дані з другої. А додавши BY NAME, наприклад,
UNION ALL BY NAME, об'єднання відбудеться по назвам колонок, при цьому не важливо в якому порядку в таблицях вони будуть, що зменшує вірогідність допустити помилку при об'єднанні до нуля.
Але це не всі оператори. Повний перелік тут. Як бачите, їх доволі небагато, і всі мають логічні назви, тому коли ви читаєте Pipe, ви вже завчасно розумієте, що за обробка відбувається в наступному блоці. Звісно, якщо використовуєте команди за прямим призначенням :)
Я думаю, ви помітили, що оператори починаються з символів “ |> “. Це своєрідний старт наступного етапу обробки. Їх можна додавати безкінечно, тим самим в більшості випадків зникає необхідність плодити все нові і нові підзапити, і придумувати їм назви в стилі “raw”, “prep”, ”final”, “super_final”, “last_final”, “the_very_last_final_I_promise”, “final2”.
“|>” не додається тільки перед FROM, бо це початок запиту, а не етап. І перед GROUP BY, бо це – частина оператора AGGREGATE.
Запит 2 – Найпопулярніші сторінки на сайті
З теорією все. Якщо ви знали SQL до цього, вам достатньо буде приблизно 1-2 годин, щоб зрозуміти принципи Pipe і напрактикуватись.
Розглянемо наступний запит, який покаже нам 10 найбільш відвідуваних сторінок.
| SQL | Pipe |
|---|
-- візьми SELECT
-- заголовки сторінок
(SELECT value.string_value FROM UNNEST(event_params) WHERE KEY = 'page_title') AS page_title,
-- порахуй кількість рядків,
COUNT(*) AS pageviews,
-- кількість юзерів,
COUNT(DISTINCT user_pseudo_id) AS users,
-- і кількість рядків поділи на кількість юзерів і округли до 2 знаків після коми
ROUND(COUNT(*) / COUNT(DISTINCT user_pseudo_id), 2) AS pageviews_per_user
-- з даних екпорту GA4
FROM
bigqueryfortests.analytics_11111111.events_20*
-- де назва івенту = page_view
WHERE event_name = 'page_view'
-- згрупуй розрахунки по заголовкам сторінок
GROUP BY 1
-- відсортуй по кількості переглядів сторінок в спадному порядку
ORDER BY 2 DESC
-- і обмеж результат до 10 значень
LIMIT 10 | -- з даних екпорту GA4 FROM bigqueryfortests.analytics_11111111.events_20*
-- візьми тільки івенти page_view
|>WHERE event_name = 'page_view'
-- порахуй кількість рядків
|>AGGREGATE
COUNT(*) AS pageviews,
-- та кількість юзерів
COUNT(DISTINCT user_pseudo_id) AS users
-- в розрізі заголовків сторінок
GROUP BY
(SELECT value.string_value FROM UNNEST(event_params) WHERE KEY = 'page_title') AS page_title
-- додай середню кількість переглядів, поділивши кількість переглядів сторінок на юзерів, і округли до 2 знаків після коми
|>EXTEND
ROUND(pageviews / users, 2) AS pageviews_per_user
-- відсортуй по кількості переглядів сторінок
|>ORDER BY pageviews DESC
-- і обмеж результат до 10 значень
|>LIMIT 10 |
В цьому прикладі помітно, що стандартний SQL додає нам “роботи”. Нам треба перескочити в WHERE, щоб зрозуміти чому COUNT(*) називається pageviews (перегляди сторінок). І для розрахунку рейту треба ще раз продублювати формули кількості переглядів і юзерів.
На Pipe ти читаєш по порядку обробки логіки, і на наступних етапах можна використовувати ті назви колонок, які вже були раніше.
Запит 3 – Відкритий e-commerce фанл з розбивкою по браузерам користувачів
Наступний запит дасть вам розуміння чи є у вас можливі технічні проблеми в фанелі в якомусь браузері.
| SQL | Pipe |
|---|
-- створи підзапит WITH events AS (
-- взявши
SELECT
-- дані про браузери користувачів
device.web_info.browser,
-- порахуй кількість користувачів
COUNT(DISTINCT user_pseudo_id) AS users,
-- кількість користувачів, які переглянули картку товару
COUNT(DISTINCT IF(event_name = 'view_item', user_pseudo_id, NULL)) AS view_item,
-- кількість користувачів, які додали товар в кошик
COUNT(DISTINCT IF(event_name = 'add_to_cart', user_pseudo_id, NULL)) AS add_to_cart,
-- кількість користувачів, які перейшли на сторінку оформлення
COUNT(DISTINCT IF(event_name = 'begin_checkout', user_pseudo_id, NULL)) AS begin_checkout,
-- кількість користувачів, які зробили замовлення
COUNT(DISTINCT IF(event_name = 'purchase', user_pseudo_id, NULL)) AS purchase
-- з даних екпорту GA4
FROM bigqueryfortests.analytics_11111111.events_20*
-- згрупуй результати по браузерам
GROUP BY 1
)
-- тепер візьми все те, що було вище
SELECT
*,
-- порахуй співвідношення тих, хто переглянув товар, до всіх користувачів, округли до двох знаків і переведи у відсотки,
ROUND(SAFE_DIVIDE(view_item, users) * 100, 2) || '%' AS view_item_rate,
-- співвідношення тих, хто додав товар в кошик, до тих, переглянув товар, округли до двох знаків і переведи у відсотки,
ROUND(SAFE_DIVIDE(add_to_cart, view_item) * 100, 2) || '%' AS add_to_cart_rate,
-- співвідношення тих, хто перейшов на сторінку оформлення, до тих, хто додав товар в кошик, округли до двох знаків і переведи у відсотки,
ROUND(SAFE_DIVIDE(begin_checkout, add_to_cart) * 100, 2) || '%' AS begin_checkout_rate,
-- співвідношення тих, хто зробив замовлення, до тих, хто перейшов на сторінку оформлення, округли до двох знаків і переведи у відсотки
ROUND(SAFE_DIVIDE(purchase, begin_checkout) * 100, 2) || '%' AS purchase_rate
-- на основі даних підзапиту
FROM events
-- і відсортуй по кількості користувачів у спадному порядку
ORDER BY users DESC | -- з даних екпорту GA4 FROM bigqueryfortests.analytics_11111111.events_20*
|>AGGREGATE
-- порахуй загальну кількість користувачів
COUNT(DISTINCT user_pseudo_id) AS users,
-- кількість користувачів, які переглянули картку товару,
COUNT(DISTINCT IF(event_name = 'view_item', user_pseudo_id, NULL)) AS view_item,
-- кількість користувачів, які додали товар в кошик,
COUNT(DISTINCT IF(event_name = 'add_to_cart', user_pseudo_id, NULL)) AS add_to_cart,
-- кількість користувачів, які перейшли на сторінку оформлення
COUNT(DISTINCT IF(event_name = 'begin_checkout', user_pseudo_id, NULL)) AS begin_checkout,
-- та кількість користувачів, які зробили замовлення
COUNT(DISTINCT IF(event_name = 'purchase', user_pseudo_id, NULL)) AS purchase
-- в розбивці по браузерам користувачів
GROUP BY
device.web_info.browser
-- додай до розрахунку
|>EXTEND
-- співвідношення тих, хто переглянув товар, до всіх користувачів, округли до двох знаків і переведи у відсотки,
ROUND(SAFE_DIVIDE(view_item, users) * 100, 2) || '%' AS view_item_rate,
-- співвідношення тих, хто додав товар в кошик, до тих, переглянув товар, округли до двох знаків і переведи у відсотки,
ROUND(SAFE_DIVIDE(add_to_cart, view_item) * 100, 2) || '%' AS add_to_cart_rate,
-- співвідношення тих, хто перейшов на сторінку оформлення, до тих, хто додав товар в кошик, округли до двох знаків і переведи у відсотки,
ROUND(SAFE_DIVIDE(begin_checkout, add_to_cart) * 100, 2) || '%' AS begin_checkout_rate,
-- співвідношення тих, хто зробив замовлення, до тих, хто перейшов на сторінку оформлення, округли до двох знаків і переведи у відсотки
ROUND(SAFE_DIVIDE(purchase, begin_checkout) * 100, 2) || '%' AS purchase_rate
-- і відсортуй по кількості користувачів у спадному порядку
|>ORDER BY users desc
|
І коли запити стають трохи довшими, можна відмітити ще один, невеличкий “профіт” – запити на Pipe зазвичай коротші, хоч і не завжди, але в переважній більшості випадків. По моїм тестам вони коротші десь на 15-20%, бували випадки і на 40%, де оброблювались дані з однієї таблиці без джойнів. Для великих запитів це істотний плюс, бо ти не втрачаєш логіку обробки, і тобі треба менше перескакувати між різними підзапитами.
Запит 4 – Звіт з GA4 Traffic Acquisition
Останнім розглянемо приклад запиту, який повертає дані з, напевно, найбільш популярного звіту в GA4 – Traffic Acquisition (Джерела трафіку).
| SQL | Pipe |
|---|
-- створи підзапит
WITH prep AS (
-- взявши
SELECT
-- primary Channel Group
session_traffic_source_last_click.cross_channel_campaign.primary_channel_group,
-- та ID сесії
CONCAT(user_pseudo_id, (SELECT value.int_value FROM UNNEST(event_params) WHERE KEY = 'ga_session_id')) AS session_id,
-- визнач чи була сесія із взаємодією
MAX(
COALESCE((
SELECT value.int_value FROM UNNEST(event_params) WHERE KEY = 'session_engaged'),
CAST((SELECT value.string_value FROM UNNEST(event_params) WHERE KEY = 'session_engaged') AS int64))) AS session_engaged,
-- порахуй суму часу взаємодії в секундах,
SUM((SELECT value.int_value FROM UNNEST(event_params) WHERE KEY = 'engagement_time_msec')) / 1000 AS engagement_time_sec,
-- кількість івентів,
COUNT(*) AS events,
-- кількість конверсій,
COUNTIF(event_name = 'purchase') AS conversions,
-- та загальний дохід
SUM(ecommerce.purchase_revenue) AS total_revenue
-- в даних експорту GA4
FROM `bigqueryfortests.analytics_11111111.events_20*`
-- згрупуй результати по Primary Channel Group і ID сесії
GROUP BY 1, 2
)
SELECT
-- тепер візьми Primary Channel Group
primary_channel_group,
-- порахуй кількість сесій
COUNT(*) AS sessions,
-- кількість сесій із взаємодією,
SUM(session_engaged) AS engaged_sessions,
-- долю сесій із взаємодією,
ROUND(SUM(session_engaged) / COUNT(*) * 100, 2) || '%' AS engagement_rate,
-- середній час взаємодії,
ROUND(SUM(engagement_time_sec) / COUNT(*), 2) AS avg_engagement_time_per_session_in_sec,
-- середню кількість подій на сесію,
ROUND(SUM(events) / COUNT(*), 2) AS events_per_session,
-- загальну кількість подій
SUM(events) AS event_count,
-- кількість конверсій,
SUM(conversions) AS conversions,
-- коєфіціент конверсії сесії
ROUND(COUNTIF(conversions >= 1) / COUNT(*) * 100, 2) || '%' AS session_conversion_rate,
-- та суму доходу
ROUND(SUM(total_revenue), 2) AS total_revenue
-- з попереднього запиту
FROM prep
-- згрупуй результати по Primary Channel Group
GROUP BY 1
-- та відсортуй результати по кількості сесій в спадному порядку
ORDER BY 2 desc
| -- з даних екпорту GA4 FROM `bigqueryfortests.analytics_11111111.events_20*`
|>SELECT
-- візьми Primary Channel Group
session_traffic_source_last_click.cross_channel_campaign.primary_channel_group,
-- ID сесії
CONCAT(user_pseudo_id, (SELECT value.int_value FROM UNNEST(event_params) WHERE KEY = 'ga_session_id')) AS session_id,
-- дані про те, чи була сесія із взаємодією формату цілого числа
(SELECT value.int_value FROM UNNEST(event_params) WHERE KEY = 'session_engaged') AS session_engaged_int,
-- та текстового,
(SELECT value.string_value FROM UNNEST(event_params) WHERE KEY = 'session_engaged') AS session_engaged_string,
-- час взаємодії
(SELECT value.int_value FROM UNNEST(event_params) WHERE KEY = 'engagement_time_msec') AS engagement_time_msec,
-- назва івенту
event_name,
-- та дохід
ecommerce.purchase_revenue
-- додай колонку з визначенням сесії із взаємодією на основі обох параметрів
|>EXTEND
COALESCE(session_engaged_int, CAST(session_engaged_string AS int64)) AS session_engaged
|>AGGREGATE
-- визнач чи була сесія із взаємодією
MAX(session_engaged) AS session_engaged,
-- порахуй час взаємодії в секундах,
SUM(engagement_time_msec) / 1000 AS engagement_time_sec,
-- кількість івентів,
COUNT(*) AS events,
-- кількість конверсій,
COUNTIF(event_name = 'purchase') AS conversions,
-- та загальний дохід
SUM(purchase_revenue) AS total_revenue
-- на рівні кожної Primary Channel Group та окремої сесії
GROUP BY
primary_channel_group,
session_id
-- тепер розрахуй
|>AGGREGATE
-- кількість сесій
COUNT(*) AS sessions,
-- кількість сесій із взаємодією
SUM(session_engaged) AS engaged_sessions,
-- долю сесій із взаємодією,
ROUND(SUM(session_engaged) / COUNT(*) * 100, 2) || '%' AS engagement_rate,
-- середній час взаємодії,
ROUND(SUM(engagement_time_sec) / COUNT(*), 2) AS avg_engagement_time_per_session_in_sec,
-- середню кількість подій на сесію,
ROUND(SUM(events) / COUNT(*), 2) AS events_per_session,
-- загальну кількість подій,
SUM(events) AS event_count,
-- кількість конверсій,
SUM(conversions) AS conversions,
-- коєфіціент конверсії сесії
ROUND(COUNTIF(conversions >= 1) / COUNT(*) * 100, 2) || '%' AS session_conversion_rate,
-- та суму доходу
ROUND(SUM(total_revenue), 2) AS total_revenue
-- для кожної Primary Channel Group
GROUP BY
primary_channel_group
-- та відсортуй результати по кількості сесій в спадному порядку
|>ORDER BY sessions desc |
Як і писала вище, запити на Pipe коротші не завжди, але незмінним залишається послідовність і лінійність, яку зрозуміти значно легше, ніж звичайний SQL.
Можливо, ви помітили – для цього прикладу і для простоти я використала поле primary_channel_group з об’єкту session_traffic_source_last_click.cross_channel_campaign. Воно відносно нове, і наче як має містити значення каналів трафіку з інтерфейсу, де джерела визначаються за принципом останнє відоме джерело. Однак до інтерфейсу у мене багато питань – він, м'яко кажучи, не ідеальний. Я вже якось проводила дослідження з іншими полями цього об'єкту – session_traffic_source_last_click.manual_campaign, які з'явились трохи раніше, і порівнювала їх з інтерфейсом. Результати по деяким проектами мене сильно здивували. Лінк на це дослідження залишу тут.
Інша справа – не попередньо оброблені Гуглом значення, а те, що лежить в основі визначення джерел – page_location і page_referrer. Логіка обробки на основі цих полів буде звісно довша, але вона допоможе виправити баги інтерфейсу і кастомізувати дані під потреби бізнесу. Ми з Максом якось проводили вебінар, де детально розібрали принципи визначення джерел в інтерфейсі і поділились скриптом на основі page_location і page_referrer. Доступ до запису і скрипта можна придбати тут.
А якщо все вищенаписане для вас "дуже цікаво, але нічого не ясно", то вам пряма дорога на курс BigQuery for Marketing, де сенсей зі своєю викладацькою майстерністю пояснює складні речі про роботу з сирими даними в BigQuery зрозумілою мовою.
Заключні думки
Сподіваюсь, мені вдалось на цих кількох прикладах познайомити вас з принципами Pipe і показати різницю зі звичайним SQL.
Я точно не агітую вас переходити "на темну сторону". Я вважаю, що потрібно знати класичний синтаксис в першу чергу, оскільки він найбільш поширений. З певними варіаціями він використовується скрізь, де треба мати справу з обробкою даних. При цьому ці "варіації" не стосуються плану виконання запитів – він однаковий у всіх діалектах.
І тут буде "але". Pipe має суттєву перевагу – він простіший і логічніший. Це дозволяє більшій кількості спеціалістів почати працювати з сирими даними, оскільки на вивчення і розуміння Pipe треба менше часу.
Для тих, хто вже працює з даними, простота і послідовність цього синтаксису сприяє кращому розумінню етапів обробки, що в свою чергу знижує вірогідність помилок при написанні складної логіки в запитах.
Резюмуючи своє враження від Pipe, можу сказати, що Google придумав не фігню :)

Завантаження коментарів…